Основы Smart Monitor Language (SML)
Smart Monitor Language (SML) — язык запросов Smart Monitor для поиска, обработки и анализа данных.
Запрос SML представляет собой последовательность команд в конвейере обработки данных. Такой формат упрощает чтение и повторное использование запросов и позволяет работать с разными источниками данных.
В статье описаны синтаксис и основные принципы работы с SML, базовые конструкции и команды, а также рекомендации по оптимизации и отладке запросов.
Архитектурная модель и принципы работы SML
Smart Monitor Language использует конвейерную модель обработки данных. Команды запроса разделяются вертикальной чертой (|): каждая команда принимает набор событий и передает результат следующей команде. В одном запросе можно объединить поиск, фильтрацию, преобразование и агрегацию данных.
Структура команды SML
Команда SML состоит из имени операции, аргументов и параметров.
Общий шаблон команды
<command> [positional arguments] [parameters] [clauses/expressions]
Ключевые элементы:
-
command— имя операции (source,search,peval,aggs,joinи другие) -
позиционные аргументы (
positional arguments) — обязательные или необязательные значения после имени команды
Пример:source nginx-1— здесь имя источникаnginx-1является позиционным аргументом -
именованные параметры (
parameters) — настройки в форматеkey=value, определяющие поведение команды
Пример:source nginx-1 qsize=5000— параметрqsizeограничивает объем выборки -
ключевые слова и предложения (
clauses) — синтаксические конструкции, специфичные для отдельных команд
Пример:byвaggs count by field,onвjoin ... on a=b,spanвtimeaggs span=1h -
выражения (
expressions) — логические условия или математические формулы
Пример:search status >= 500в командеsearchилиcount * 100вeval -
подзапросы — вложенные конвейеры, заключаемые в квадратные скобки
[...]. Используются в командах сопоставления данных, таких какjoinилиappend
Правила записи и типы данных
Для корректной интерпретации запроса аналитическим движком SME (Smart Monitor Engine) соблюдайте следующие правила:
-
Строковые значения, содержащие пробелы или спецсимволы, необходимо заключать в одинарные (
' ') или двойные (" ") кавычки. В остальных случаях кавычки необязательны -
Числовые значения (
100,0.5) и булевы константы (true,false) записываются без кавычек -
Для обращения ко вложенным структурам используется «точечная» нотация (например,
user.agent.browser) -
Имена команд регистронезависимы, однако рекомендуется придерживаться нижнего регистра для единообразия текста запроса
Базовый синтаксис и структура запроса
Структура запроса определяет порядок извлечения и обработки данных. Ее понимание помогает избегать синтаксических ошибок и делать запросы понятнее.
Структура запроса
Запрос всегда начинается с определения источника данных (команда генерации или загрузки), за которой следует цепочка пайплайнов.
Структура типового запроса на SML представлена ниже:
source log-index qsize=5000  /* 1. Загрузка данных */
| search log_level="error"   /* 2. Фильтрация */
| peval host=lower(host)     /* 3. Трансформация/Вычисление */
| aggs count by host         /* 4. Агрегация */
Запрос загружает данные из источника log-index, оставляет ошибки, приводит значение поля host к нижнему регистру и подсчитывает события для каждого хоста.
Необязательно ставить вертикальную черту (|) перед каждой командой одного типа: например, peval позволяет вычислять несколько значений, перечисленных через запятую. Для удобства чтения размещайте каждую команду на отдельной строке.
Комментарии
SML поддерживает многострочные комментарии в стиле языка C. Они игнорируются при выполнении запроса и позволяют документировать сложную логику.
/* Этот блок фильтрует только успешные запросы
   и агрегирует количество событий по коду ответа
*/
| search status < 400
| aggs count by status
Источники данных
Концепция Search Anywhere позволяет искать данные в разных источниках. Поддерживаются четыре типа хранилищ:
- OpenSearch
- Elasticsearch
- ClickHouse
- Hadoop
Базовая структура SML-запроса одинакова для поисковых, аналитических и распределенных хранилищ. Поэтому общую логику запроса можно использовать с разными источниками данных.
Для получения данных из OpenSearch и Elasticsearch используйте команду source, а затем укажите имя индекса или паттерн индекса, например:
source employee_list-0073
source employee_list
Для получения данных из ClickHouse используйте команду clicksource или source. Укажите имя базы данных и таблицы в формате db_name.table_name, например:
clicksource 'hr.employee_list'
| search status="Уволен"
Для получения данных из Hadoop используйте команду hdhsource или source. Формат имени базы данных и таблицы такой же, как для ClickHouse:
hdhsource 'hr.employee_list'
| search status="Уволен"
При работе с OpenSearch данные из нескольких источников можно объединить в одном запросе. Для этого укажите необязательный параметр append после команды source:
source sm_cs_iam_indexes, sm_servers_indexes append = true
Чтобы экранировать специальные символы в имени источника, заключите его в одинарные кавычки:
source '*-antifraud-event-*'
Символ * в имени источника используется как маска для выбора нескольких индексов:
source .smos_internal-*
Запрос вернет данные из индексов вида .smos_internal-2026.12, .smos_internal-2026.13 и так далее.
Подробнее см. описание команды source.
После указания источника можно выполнять поиск, фильтрацию и агрегацию данных.
Работа со справочниками
Справочники (lookup) можно использовать для обогащения событий данными из других источников или как самостоятельный источник.
Для загрузки данных из справочника в SML используйте команду inputlookup. Она добавляет данные справочника в конвейер обработки.
Пример загрузки и использования данных из справочника:
| inputlookup whitelist_lookup
| aggs count(user_ip) as ip
Генерация тестовых данных
Команда makeresults создает одно или несколько пустых событий непосредственно в запросе, без обращения к внешним источникам. Затем их можно дополнить полями с помощью команд вычисления и преобразования.
| makeresults
| eval numbers = {"5", "9", "7"}
| stats max(numbers) as maximum
Пример возвращает максимальное число из поля numbers типа multivalue.
Временные параметры
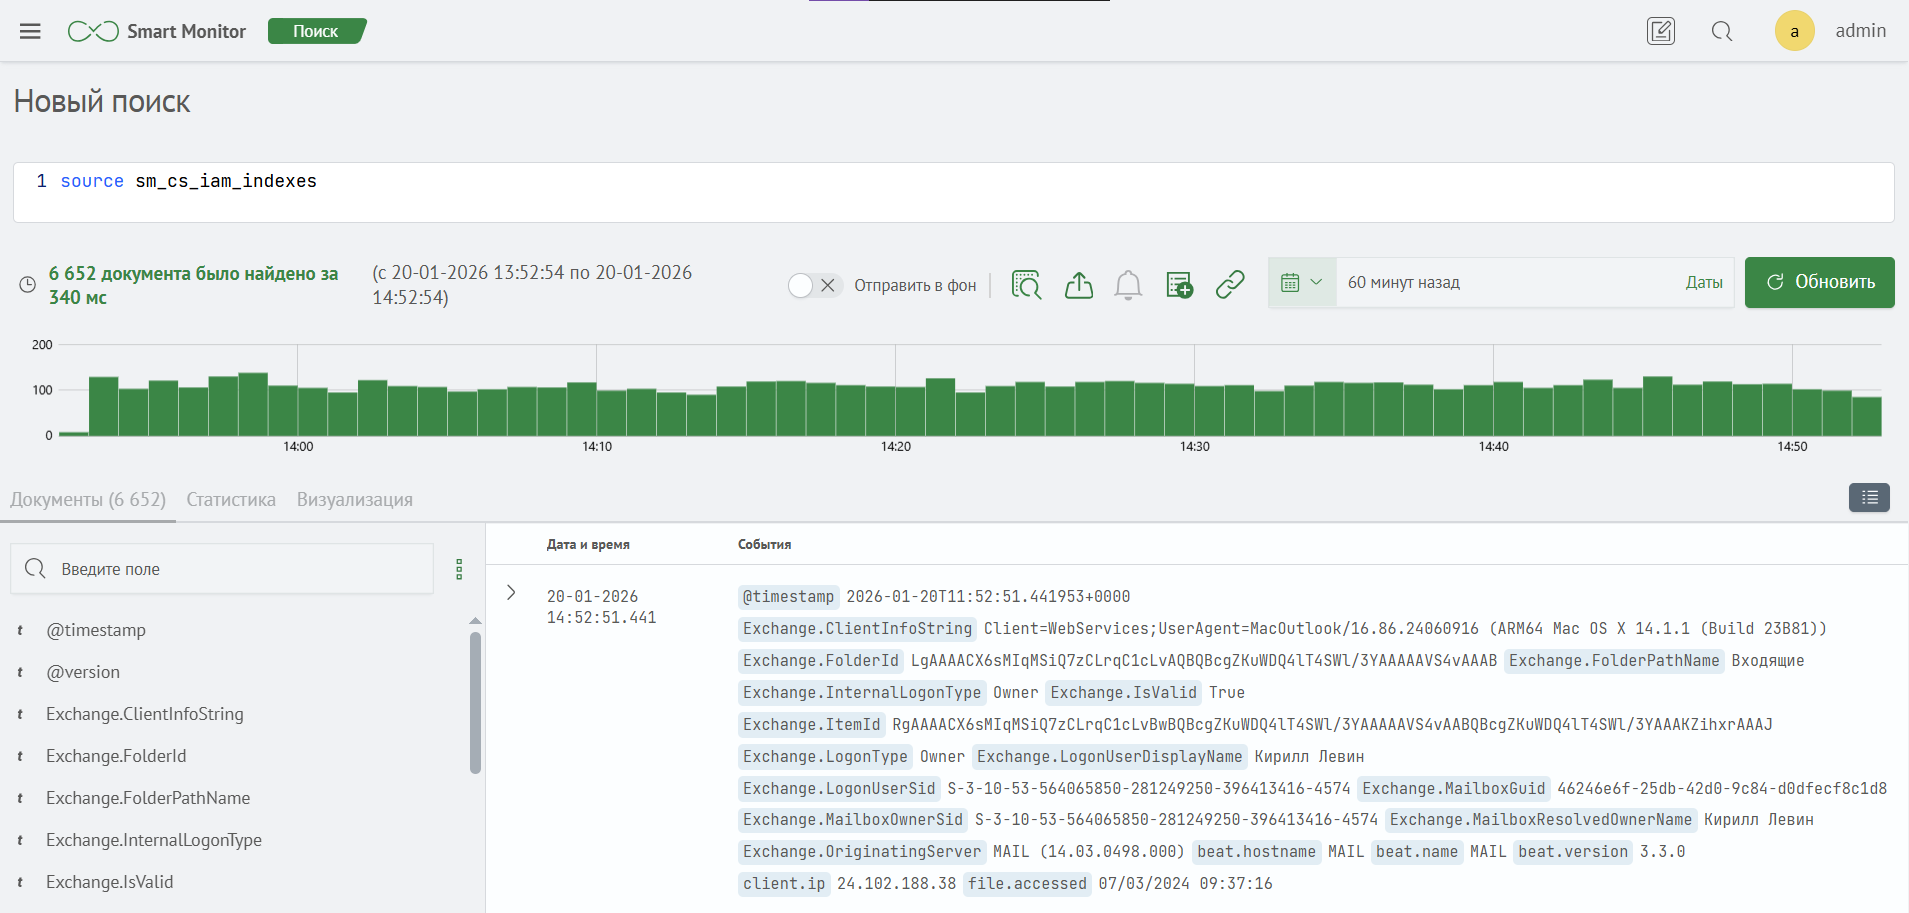
Результаты поиска в Smart Monitor агрегируются за временной интервал, заданный фильтром на странице поиска или параметрами earliest и latest команды source. Результаты сортируются по убыванию временной метки. За указанный период строится гистограмма.
Гистограмма отображается, если для индекса настроен шаблон. Если шаблон не настроен, укажите поле временной метки параметром timefield сразу после команды source:
source nginx-logs-* timefield=@timestamp
| timeaggs count
Если поле временной метки не указано и шаблон не настроен, Smart Monitor покажет количество найденных документов, но не сами события. Например, запрос source .smos_incident-* вернет N документов было найдено, а список событий останется пустым. Чтобы отобразить события, укажите поле временной метки: source .smos_incident-* timefield=search_params.earliest_time.
Пример поискового запроса с гистограммой приведен ниже.
Подробнее о временных диапазонах см. раздел документации.
Параметр qsize
Параметр qsize ограничивает объем данных, обрабатываемых в памяти при выполнении запроса. Например:
source internal_audit-* qsize=2000
Запрос ограничит результат первыми 2000 событиями.
Увеличение qsize повышает нагрузку на систему, в частности расход оперативной памяти.
Уровни выполнения команд в Smart Monitor
По уровню выполнения команды Smart Monitor делятся на две группы:
-
Команды, выполняющие операции над данными с помощью внутренних механизмов хранилища
-
Команды, выполняемые «в памяти» с помощью аналитического движка для обработки данных SME (Smart Monitor Engine)
Команды первой группы выполняются быстрее благодаря внутренним механизмам хранилища. Их можно использовать, если до них в конвейере расположены только команды получения данных из источников и нет команд, выполняемых «в памяти». К первой группе относятся source, search, peval, timeaggs и aggs.
При использовании команд, выполняемых «в памяти», по умолчанию возвращаются первые 1000 результатов. Чтобы увеличить объем обрабатываемых данных, задайте параметр qsize для команды source.
Особенности построения запросов для типов данных text и keyword
В источниках OpenSearch и Elasticsearch строковые поля часто индексируются двумя способами. Этот механизм называется мультиполями (multi-fields). Для работы с такими полями в SML важно различать их назначение.
| Тип поля | Механизм обработки | Рекомендуемое использование в SML |
|---|---|---|
text (базовое поле) | Разбивается на отдельные токены (слова). | Полнотекстовый поиск, поиск подстрок и частичных совпадений. |
keyword (суффикс .keyword) | Хранится как единая неразрывная строка. | Точное совпадение, агрегация, группировка. |
Выбор между базовым именем поля и именем с суффиксом .keyword определяет точность фильтрации в команде search. Поля .keyword также снижают нагрузку: в отличие от text, они не проходят полнотекстовый анализ и обрабатываются как единая строка.
Если в маппинге поле уже имеет тип keyword, добавлять суффикс .keyword не нужно: такого под-поля нет, и запрос вернет пустой результат или ошибку. Суффикс .keyword используют только для полей типа text, у которых есть мультиполе.
Например, запрос вернет документы, в поле event.original которых содержится слово memory:
source linux-logs-*
| search event.original="memory"
Следующий запрос вернет документы, в которых поле event.original содержит только слово memory:
source linux-logs-*
| search event.original.keyword="memory"
Макросы
Макросы — повторно используемые фрагменты SML-запросов. Они упрощают сложные запросы и позволяют стандартизировать аналитическую логику. Часто используемое выражение или фильтр можно сохранить как макрос и вызывать по короткому имени.
Чтобы вставить макрос в запрос, поставьте символ обратной кавычки перед его именем. При выполнении запроса Smart Monitor заменит имя макроса его содержимым.
source nginx-*
| `filter_errors`  /* Вызов макроса, содержащего логику фильтрации */
| aggs count by host
Фильтрация и логические условия
search
Команда search ищет и фильтрует данные. Условия задаются в формате field=value.
Пример выполнения поиска:
source internal_audit-*
| search log_level="info"
SML поддерживает операторы AND, OR, NOT. По умолчанию между условиями в search действует оператор AND.
В командах eval, where и like используются шаблоны с символом %, а в search — с символом *. Также поддерживаются поиск по регулярным выражениям (regex) и по маске подсети (CIDR).
Помимо поиска по полям, Smart Monitor поддерживает полнотекстовый поиск. Например:
source internal_audit-*
| search "warning"
Запрос ищет слово warning во всех полях документов индекса internal_audit-*.
Префикс ~ перед кавычками (~"фраза") выполняет поиск отдельных слов без точного совпадения. Например:
source internal_audit-*
| search ~"getting access"
Запрос ищет документы, содержащие слова getting или access в любом текстовом поле.
Подробнее о полнотекстовом поиске см. отдельную статью.
where
Команда where также фильтрует данные. Условия задаются в формате сравнения, например where count>5 или where user=="admin".
В SML для where используется двойное равенство == в отличие от одиночного = в search.
Команда where поддерживает функции like(), match(), cidrmatch(), in() и другие.
Приоритет операторов
В search оператор AND выполняется раньше OR, а в where — наоборот. Для сложных условий используйте скобки, например:
| search host="mail" AND NOT (code="4625" OR code="4624")
Операторы сравнения и кавычки
SML поддерживает операторы =, !=, <, >, <= и >=. При сравнении чисел используется арифметическое сравнение, а строк — сравнение полных значений. Для поиска по части строки используйте символы подстановки. Если значение содержит разделители или специальные символы, заключите его в двойные кавычки ("). Обратный слеш (\) необходимо экранировать вторым обратным слешем:
| search app_path="C:\\Windows\\cmd.exe"
Подробнее о построении выражений в запросах SML см. раздел Выражения.
Агрегация и статистика
aggs и stats
Для агрегации данных в Smart Monitor используются команды aggs и stats. Команда aggs выполняет операции на уровне хранилища и обычно обрабатывает данные быстрее, чем stats. Она поддерживает большинство функций stats, включая математические (max, min, sum, perc) и функции для работы с массивами (count, values, earliest). Для обработки неограниченного количества уникальных значений используйте параметр composite=true.
timeaggs и timechart
Команды timechart и timeaggs агрегируют данные по времени, но выполняются на разных уровнях: timeaggs — на уровне хранилища, а timechart — в памяти. Поэтому timeaggs обычно работает быстрее. Команда поддерживает функции count, avg, dc и другие, а также аргументы span, timefield, limit и другие.
eventstats и streamstats
Для статистических операций Smart Monitor предоставляет команды eventstats и streamstats. Команда eventstats сохраняет результаты в новом поле, а streamstats обрабатывает данные в потоковом режиме.
Преобразование и вычисление полей
peval и eval
Команда peval аналогична eval, но использует внутренние механизмы хранилища.
Команда eval в Smart Monitor поддерживает функции преобразования и вычисления данных, в том числе временные, криптографические и математические.
Пример использования команд peval/eval:
| peval agent = agent.keyword + port
В примере создается поле agent, объединяющее значения полей agent.keyword и port.
Важной особенностью команды eval в SML является невозможность использования команды в статистических выражениях, как, например, | stats count(eval(status="404")) AS error_count. В Smart Monitor команды peval и eval являются самостоятельными и не могут встраиваться как аргументы в другие команды — за исключением подзапросов в квадратных скобках [...].
Прочие команды обработки
В Smart Monitor также доступны другие команды обработки данных:
-
fields— оставляет или исключает поля -
dedup— удаляет дубликаты по полям -
sort— сортирует данные -
head— возвращает первые N результатов запроса -
mvexpand— преобразует multivalue-поля в несколько событий -
rename— переименовывает поля
Оптимизация запросов SML
Производительность SML-запроса зависит от порядка команд и объема данных, обрабатываемых на каждом этапе конвейера. Чтобы сократить число событий до следующих операций, задавайте условия поиска сразу после источника.
Для оптимизации используйте команды уровня хранилища (search, peval, aggs и timeaggs): они задействуют внутренние механизмы источника и обычно работают быстрее команд, выполняемых в памяти аналитического движка. Это особенно важно при агрегации больших объемов данных.
Подробные рекомендации и примеры оптимизации SML-запросов приведены в статье Советы по оптимизации SML.
Диагностика и отладка
Эффективное использование Smart Monitor Language предполагает владение инструментами диагностики и методами отладки запросов, которые позволяют локализовать ошибки в цепочках пайплайнов и минимизировать избыточную нагрузку на ресурсы платформы.
Типичные ошибки в SML-запросах
При выполнении запросов в Smart Monitor могут возникать ошибки на разных уровнях: синтаксическом (парсинг запроса), семантическом (логика условий) или производительном (ресурсы системы).
Синтаксические ошибки
- Отсутствие вертикальной черты (
|) для новой команды
Пример:
source winevents
search agent.id = "5436647"
- Незакрытые скобки в запросе. В случаях, если в запросе открыта, но не закрыта скобка, возникнет синтаксическая ошибка
Пример:
source sm_users
| peval user.name=mvindex(split(user.name, "@", 0)
- Неправильное использование кавычек или спецсимволов. Строки с пробелами или спецсимволами заключайте в кавычки (
" "или' '). Обратный слеш (\) необходимо экранировать (\\)
source *-internal*
| search user_name = Иван Иванов
- Опечатки в именах команд или параметров
Семантические ошибки
- Использование неверного оператора сравнения. Наиболее частая ошибка — применение оператора
=в командеwhere
| where status = 500
- Неверные ожидания от полнотекстового поиска. Использование команды
searchбез указания поля выполняет полнотекстовый поиск по всем текстовым полям, что может приводить к большому количеству нерелевантных результатов
| search "error"
В большинстве случаев предпочтительнее явно указывать поле поиска.
Ошибки, связанные с типами данных
Ошибки данного класса возникают при некорректном использовании типов полей, особенно при работе с OpenSearch и Elasticsearch.
- Агрегация по полям типа text
Поля типа text предназначены для полнотекстового поиска и не подходят для агрегаций.
При этом такой подход оправдан только для полей с ограниченным набором значений (статус, тип, хост и т.д.). Поля вроде message или event.original, содержащие произвольный текст, лучше разбивать на конкретные поля на уровне парсера — агрегация по ним через .keyword может привести к проблемам с производительностью.
| aggs count by message
Для агрегаций следует использовать поле с суффиксом .keyword.
- Сравнение строк и чисел без приведения типов
Сравнение строковых значений с числовыми условиями может приводить к некорректным результатам или пустой выборке.
Ошибки, связанные с моделью выполнения команд
Smart Monitor выполняет команды на разных уровнях — на уровне хранилища или в памяти аналитического движка. Нарушение последовательности применения команд разного уровня выполнения приводит к ошибкам и некорректным результатам.
- Использование команд уровня хранилища после команд в памяти
Если перед командой уровня хранилища используется команда, работающая в памяти, операция не будет выполнена:
| eval host_lc = lower(host)
| aggs count by host_lc
В данном случае использование команды eval исключает использование команды aggs, работающей на уровне хранилища. Оптимальный вариант — применение peval вместо eval. Альтернативный, но не лучший вариант — использование stats после eval.
- Проблемы с ограничением объема данных
При использовании команд в памяти результаты запроса по умолчанию ограничиваются первой тысячей событий, если в запросе явно не указан параметр qsize.
Ошибки из-за деградации производительности
При выполнении тяжелых запросов с чрезмерно завышенным значением возвращаемых документов в параметре qsize и сложными агрегациями могут возникнуть следующие ошибки:
-
Failed to execute phase [fetch]— ошибка на этапе получения документов из шардов OpenSearch/Elasticsearch при попытке загрузить в память большое число результатов -
Command RAM limit exceeded— запрос превысил допустимый лимит оперативной памяти для выполнения -
Request failed with status code 502— ошибка шлюза, может означать, что сервер не успел обработать тяжелый запрос или соединение было разорвано из-за перегрузки или таймаута -
Search cancelled - search timeout exceeded— выполнение запроса было прервано из-за превышения допустимого времени выполнения
Еще одна причина деградации производительности, не связанная напрямую с запросом, — mapping explosion: ситуация, когда индекс содержит слишком большое количество динамически созданных полей. В этом случае медленная работа запроса — следствие проблемы на уровне индекса, а не SML-запроса.
Поэтапная отладка
Поскольку SML-запрос выполняется последовательно, ошибку легче всего найти, проверяя каждый этап конвейера по отдельности. Если написанный запрос не работает или работает не так, как ожидалось, стоит воспользоваться методом последовательного наращивания логики.
- Валидация источника
Первоначальный этап диагностики заключается в проверке доступности данных в выбранном источнике и временном интервале. Для этого выполняется базовая команда source без дополнительных фильтров и преобразований:
source nginx-logs-*
При отсутствии результатов следует проверить корректность имени индекса (паттерна) и настройки временного диапазона поиска.
- Метод последовательного наращивания конвейера
Локализация ошибки достигается путем поочередного добавления команд в запрос. Проверка промежуточного результата осуществляется после каждого нового этапа:
-
фильтрация и первичный отбор (
search,where). Проверяется точность вхождения событий в выборку. Ошибки на этом уровне приводят к пустому результату или избыточности данных -
извлечение данных из неструктурированных полей (
rex,spath). При работе с логами или JSON проверяется корректность работы регулярных выражений и парсеров. Если поле не извлечено на этом этапе, все последующие команды не смогут к нему обратиться -
преобразование и вычисление полей (
eval/peval,rename). Проверяется корректность математических операций, конкатенации строк и приведения типов -
обогащение данных (
lookup,join,append). Проверяется корректность сопоставления с внешними справочниками. На этом этапе выявляются несовпадения в названиях и типах полей в основном потоке и в справочнике -
операции агрегации и расчет статистики (
aggs/stats,timeaggs/timechart). Проверяется правильность группировки и точность функций. Ошибки часто связаны с неверным выбором функции (например,countвместоdc) -
манипуляция набором данных (
dedup,sort,mvexpand). Проверяется корректность изменения структуры набора событий: удаление дублей, сортировка или развертывание многозначных полей -
финальное форматирование (
table,fields). На последнем этапе проверяется состав возвращаемых данных
Если на определенном этапе запрос перестает корректно работать, то это позволяет однозначно определить проблемную команду.
- Использование комментариев для изоляции блоков
Для временного исключения частей запроса без их удаления применяются многострочные комментарии /* ... */. Это позволяет ограничить выполнение запроса определенными командами:
source internal_audit-*
| search status="error"
/* | eval error_code = upper(code)
| aggs count by error_code
*/
В данном примере выполнение завершится после команды search, что позволит увидеть промежуточный набор событий.
- Ограничение результатов запроса
При работе с большим числом полей с целью отладки значений только в определенных из них рекомендуется ограничивать набор полей командами fields и table.
source users
| peval full_name = first_name + " " + last_name
| table @timestamp, first_name, last_name, full_name
Статистика запроса
Статистика выполнения запроса содержит длительности этапов, количество входящих и исходящих документов, объем обрабатываемых данных и сводку обращений к хранилищам. Для ClickHouse также доступны серверные показатели CPU, памяти, прочитанных строк и байтов.
Чтобы включить статистику в API поиска, задайте calculateExecutionCost: "ON". Значение OFF отключает ее. Подробнее см. раздел API SME.
Чтобы открыть статистику в интерфейсе:
- Выполните поисковый запрос
- Под результатами нажмите строку со сводной информацией о количестве документов и времени выполнения
- В окне
Статистика запросаоткройте вкладкуВыполнение

Общее время запроса и длительности отдельных этапов — разные показатели. Время вложенных этапов может учитываться во времени родительского этапа, а длительности параллельных обращений к хранилищам складываются.

Чтобы обновить серверные показатели ClickHouse, разверните блок Ресурсы хранилища и нажмите значок обновления справа от его заголовка. Если записи журнала еще не появились, повторите обновление позже.
Сообщение Обновление недоступно: у этого поиска нет контекста телеметрии. означает, что для результата отсутствует контекст, необходимый для обновления показателей.

Назначение показателей и порядок получения данных ClickHouse описаны в разделе Статистика выполнения запроса.
Мониторинг производительности запросов
Модуль Самомониторинг предоставляет дашборд Мониторинг производительности запросов с метриками фаз выполнения запросов. Эти данные помогают оценить поисковую нагрузку.
