Дашборд «Мониторинг производительности запросов»
Описание статьи
Дашборд используется для анализа поисковых операций на выбранном узле кластера Smart Monitor. Он показывает текущую активность фаз Query и Fetch, состояние scroll-контекстов, изменение количества операций и затраченного времени, а также связанные события из журналов SME.
Состав дашборда
Глобальные и локальные фильтры
На дашборде доступны следующие элементы управления:
Периодзадает временной диапазон просмотра данныхНодавыбирает узел, по которому анализируется поисковая нагрузкаВременной интервалзадает шаг агрегации временных графиков
Метрики дашборда
Верхние индикаторы поисковой активности

| Панель | Что показывает | Когда смотреть |
|---|---|---|
Query | Количество активных операций в фазе поиска. На этой фазе обрабатываются условия запроса, фильтры, сортировки и агрегации. | В начале диагностики поисковой задержки, особенно если растет время выполнения запросов или появляются очереди в пуле search. |
Fetch | Количество активных операций извлечения найденных документов и формирования данных ответа. | Когда задержка может быть связана с большим ответом, тяжелым _source, подсветкой, большим числом полей или чтением с диска. |
Scroll | Количество активных операций последовательной выгрузки данных через scroll. | Когда выполняются массовые выгрузки, интеграционные задания или длинные чтения больших наборов документов. |
Ориентиры штатной работы: число текущих операций меняется вместе с нагрузкой и возвращается к обычному диапазону.
Когда нужна дополнительная проверка: устойчивый рост стоит проверять вместе с длительностью операций, очередью пула search, CPU и вводом-выводом.
Значения верхних индикаторов полезны для быстрой оценки текущей активности, но для выводов их нужно сопоставлять с временными графиками, журналами и ресурсными метриками узла.
Метрики фазы Query
| Панель | Что показывает | Когда смотреть | Ориентиры штатной работы | Когда нужна дополнительная проверка |
|---|---|---|---|---|
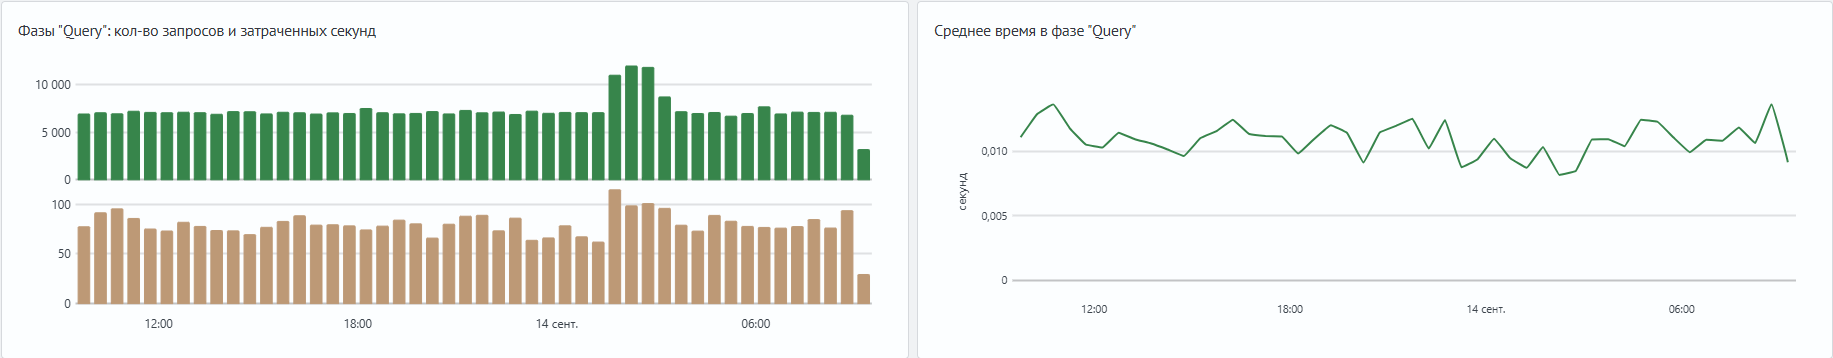
| «Фазы "Query": кол-во запросов и затраченных секунд» | Количество операций Query за интервал и суммарное время, затраченное на их выполнение. | Когда нужно понять, выросла ли сама поисковая нагрузка или каждая операция стала выполняться дольше. | Суммарное время меняется соразмерно количеству шардовых операций. | Если суммарное время растет быстрее количества операций, стоит проверить среднюю длительность, состав запросов и ресурсы узла. |
| «Среднее время в фазе "Query"» | Расчетное среднее время одной операции Query за интервал. | При подозрении на обработку большого объема данных, тяжелые фильтры, агрегации, скрипты, широкий временной диапазон или поиск по большому числу шардов. | Значение соответствует обычному уровню для сопоставимого типа запросов и не приводит к нарушению работы. | Устойчивый рост при стабильном количестве операций может означать увеличение потребления ресурсов одной шардовой операции. Причина уточняется по запросам, числу шардов, очередям и ресурсам. |
Если растет среднее время Query, уточняйте состав операций на дашборде «Число запросов в кластере по типу»: там можно проверить поисковые actions, длительные задачи и связь дочерних операций с parent task ID. Если рост совпадает с очередями или отклоненными операциями (rejected) в thread pool, переходите к дашборду «Мониторинг ресурсов ноды».
Метрики фазы Fetch
| Панель | Что показывает | Когда смотреть | Ориентиры штатной работы / Когда нужна дополнительная проверка |
|---|---|---|---|
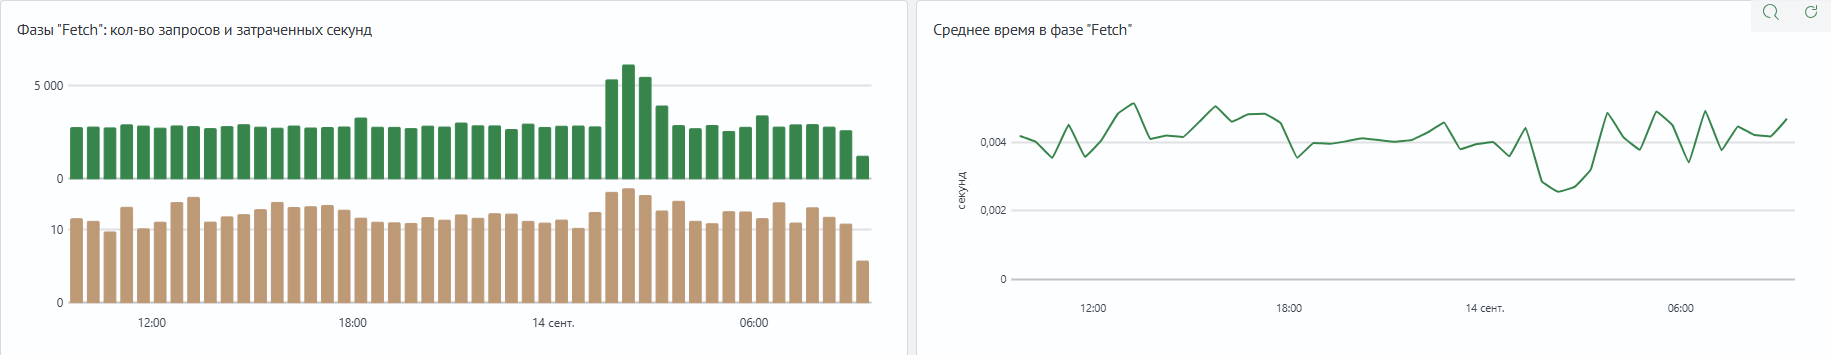
| «Фазы "Fetch": кол-во запросов и затраченных секунд» | Количество операций Fetch за интервал и суммарное время, затраченное на извлечение данных ответа. | Когда поисковая фаза завершается, но запрос долго получает документы или возвращает большой объем данных. | Аналогично панелям фазы Query. |
| «Среднее время в фазе "Fetch"» | Расчетное среднее время одной операции Fetch за интервал. | При большом size, тяжелом _source, подсветке, большом количестве возвращаемых полей или признаках медленного чтения. | Аналогично панелям фазы Query. |
Если растет Fetch, сверяйте этот период с дашбордом «Мониторинг ресурсов ноды»: важны CPU, память, заполненность хранилища, объем чтения/записи и показатели пула search. Если вместе с этим растет использование heap, direct buffer или паузы GC, продолжайте проверку на дашборде «Мониторинг JVM ноды».
Метрики операций Scroll
| Панель | Что показывает | Когда смотреть | Ориентиры штатной работы | Когда нужна дополнительная проверка |
|---|---|---|---|---|
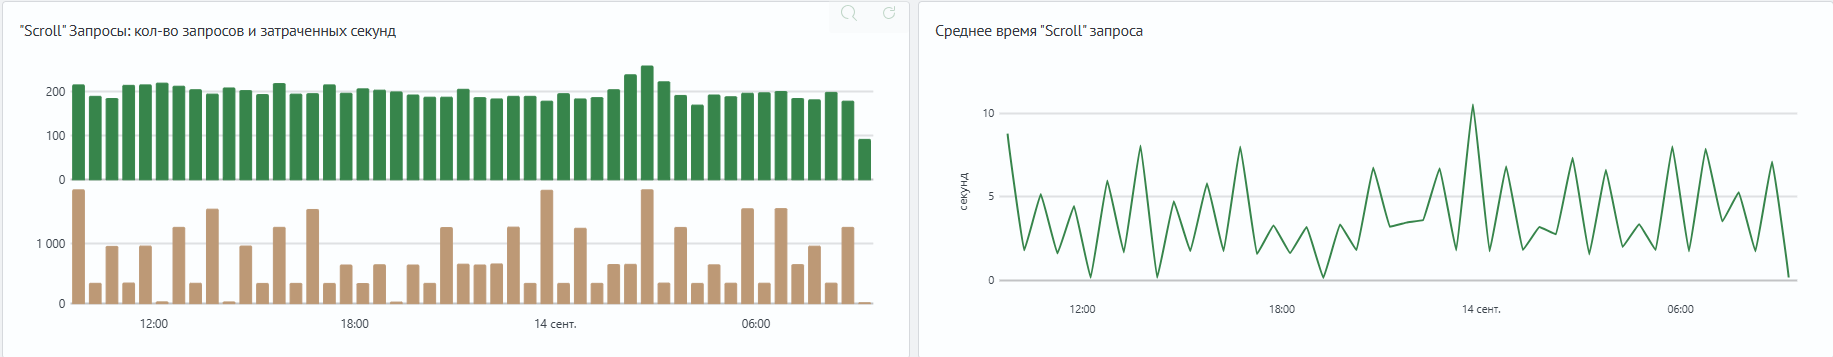
| «"Scroll" Запросы: кол-во запросов и затраченных секунд» | Количество операций Scroll за интервал и суммарное время, затраченное на последовательную выгрузку данных. | Когда нужно оценить нагрузку от массовых выгрузок, отчетов или интеграционных чтений. | Изменение соответствует известным выгрузкам и не влияет на состояние системы. | Продолжительный рост времени или числа операций стоит сопоставить с объемом выгрузки, открытыми контекстами, вводом-выводом и памятью. |
| «Среднее время "Scroll" запроса» | Расчетное среднее время одной операции Scroll за интервал. | Когда выгрузка больших наборов данных начинает занимать существенно больше времени или влияет на соседние поисковые операции. | Значение сопоставимо для выгрузок одинакового объема и структуры. | Рост следует оценивать относительно требований к конкретной выгрузке и влияния на другие запросы; он не доказывает проблему без контекста размера данных. |
Рост Scroll проверяйте вместе с ресурсами узла: на дашборде «Мониторинг ресурсов ноды» смотрите CPU, память, ввод-вывод, HTTP-соединения, файловые дескрипторы и очереди thread pool. Если в тот же период растет использование heap или direct buffer, проверьте дашборд «Мониторинг JVM ноды».
Журнальные панели
| Панель | Что показывает | Когда смотреть |
|---|---|---|
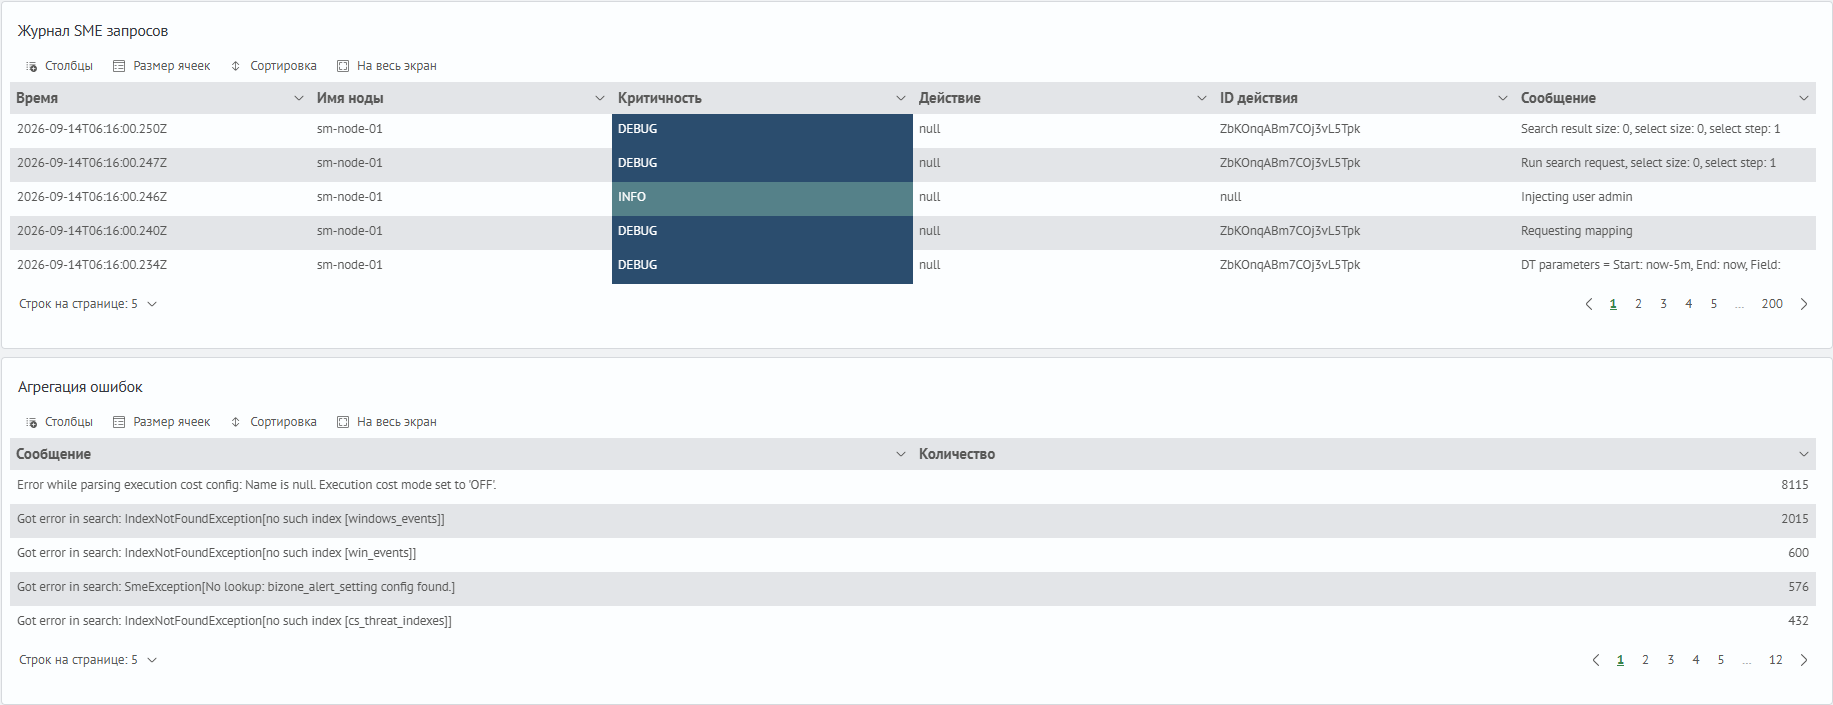
| «Журнал SME запросов» | События, связанные с выполнением поисковых операций: время, узел, критичность, действие, идентификатор действия и сообщение. | Когда нужно перейти от графика к конкретному запросу, клиенту, ошибке или периоду выполнения. |
| «Агрегация ошибок» | Повторяющиеся предупреждения и ошибки, сгруппированные по общему признаку сообщения. | Когда нужно оценить массовость однотипной проблемы и выбрать события для детального разбора. |
Журналы используйте после того, как по графикам определены интервал и затронутые узлы. Если ошибки поиска совпадают с изменением статуса кластера, снижением доступности шардов или потерей узлов, продолжайте проверку на дашборде «Состояние кластера».
Как читать временные показатели
Метрики Query, Fetch и Scroll относятся к операциям на уровне шардов. Поэтому их нельзя напрямую приравнивать к количеству уникальных клиентских запросов или полной задержке ответа клиенту.
Графики количества и суммарного времени нужно анализировать вместе:
- если растет только количество операций, нагрузка могла увеличиться без деградации отдельного запроса
- если количество операций стабильно, а суммарное и среднее время растут, каждая операция стала использовать больше ресурсов
- если одновременно растут количество, суммарное время и среднее время, узел обрабатывает больше операций, и каждая из них требует больше времени
Среднее время на графиках является расчетной величиной за выбранный интервал. Оно помогает найти проблемный участок, но не заменяет анализ конкретного запроса, числа затронутых шардов, параметров ответа, ресурсов узла и событий в журналах.
Суммарное время шардовых операций может накапливаться параллельно на нескольких шардах и узлах. Его нельзя напрямую трактовать как время ответа одного клиентского запроса.
Типовые сценарии
Рост расчетного времени поисковых операций
Одновременный рост количества шардовых операций, их суммарного времени и расчетного среднего времени указывает на период, требующий дополнительной проверки. Дашборд не определяет конкретный клиентский запрос и причину изменения: данная ситуация может быть связана с изменением объема или сложности запросов, числа затронутых шардов, параметров ответа, распределения данных либо ресурсной нагрузки.
На графиках это проявляется так:
- панель
Фазы "Query": кол-во запросов и затраченных секундпоказывает одновременный рост количества шардовых query-операций и их суммарного времени - панель
Среднее время в фазе "Query"показывает увеличение расчетного времени операции. Универсальный допустимый порог дашбордом не задан - панели
Фазы "Fetch": кол-во запросов и затраченных секундиСреднее время в фазе "Fetch"показывают аналогичное изменение для fetch-операций - панели
"Scroll" Запросы: кол-во запросов и затраченных секундиСреднее время "Scroll" запросапоказывают изменение scroll-операций. Эти панели не отражают число открытых контекстов
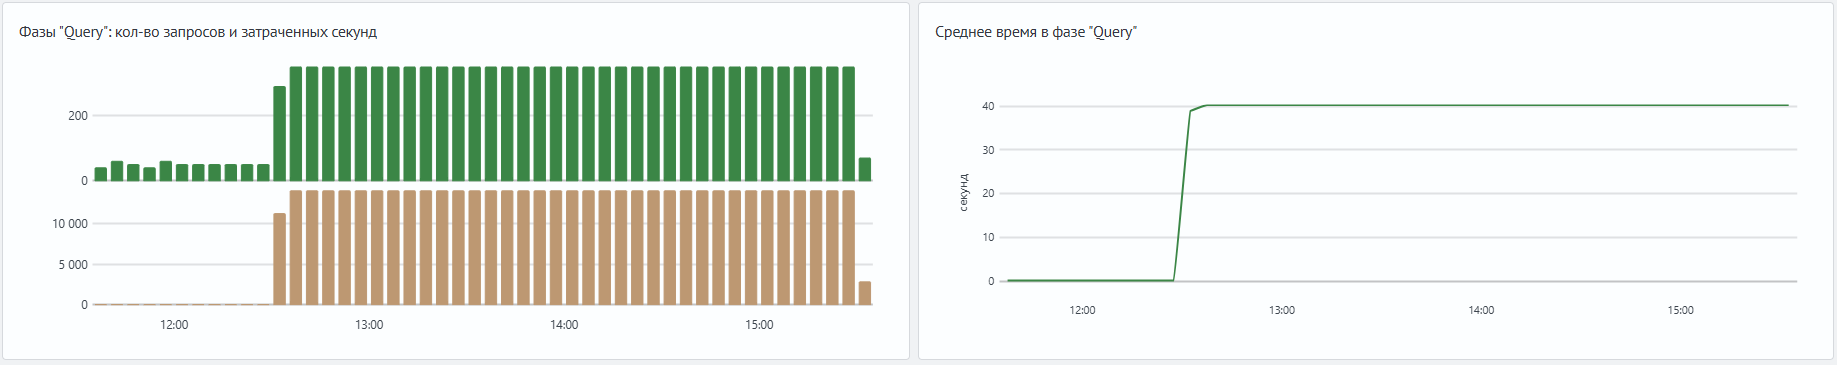

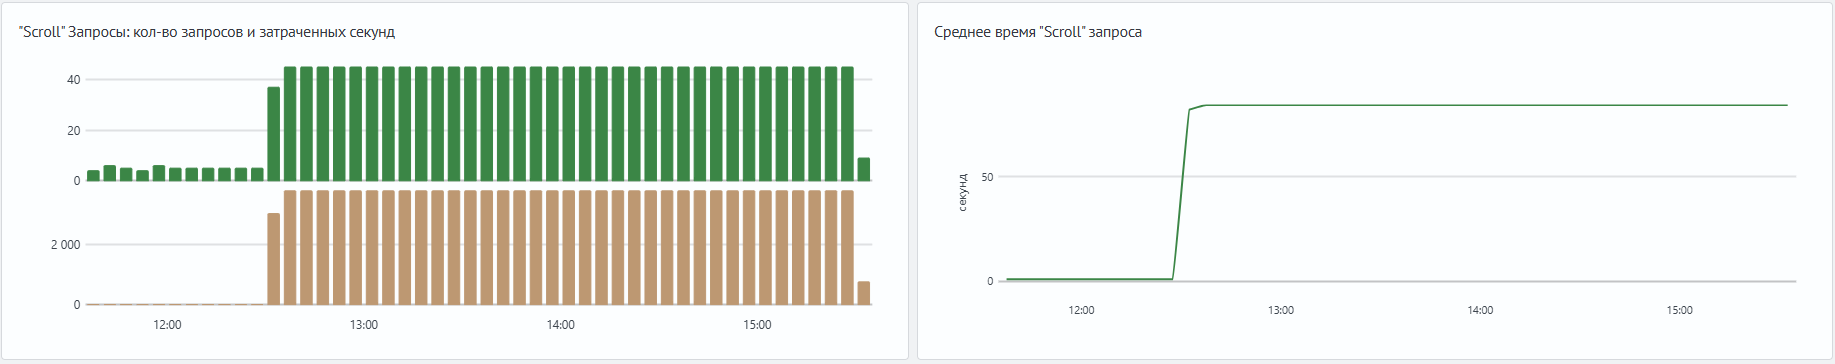
На изображениях после 12:30 увеличиваются приросты количества шардовых операций и их суммарного времени. Расчетное среднее время Query держится около 40 секунд, Fetch — около 32 секунд, Scroll — около 80 секунд. Такая картина показывает продолжительный рост времени шардовых поисковых операций, но не доказывает, что все три панели относятся к одному клиентскому запросу или одной scroll-сессии.
Для диагностики:
- Зафиксируйте интервал роста и выбранный узел
- В панели
Журнал SME запросоввручную отберите записи этого узла по столбцуИмя ноды, поскольку глобальнаяНодана журнал не действует - Сопоставьте период с дашбордом «Число запросов в кластере по типу»
- Проверьте CPU, память, чтение и показатели пула
searchна дашборде «Мониторинг ресурсов ноды» - Для конкретного запроса проверьте число затронутых шардов, параметры
size,_source, агрегации и профиль выполнения
В многоуровневой архитектуре начинайте с узлов, на которых размещены шарды запрошенных индексов. Это могут быть уровни hot, warm или cold в зависимости от временного диапазона и распределения данных. Сравнивайте узлы одинаковой роли и конфигурации.
Ненулевые шардовые поисковые метрики на узле с ролью master сами по себе не доказывают ошибку конфигурации: сначала проверьте совмещение ролей, размещение шардов и маршрутизацию.