Дашборд «Мониторинг JVM ноды»
Описание статьи
Дашборд используется для анализа состояния JVM на выбранном узле кластера Smart Monitor. Он помогает оценить потоковую активность, использование heap и non-heap памяти, потребление direct buffer и поведение GC.
Панели помогают обнаружить признаки давления на память, рост количества потоков и увеличение времени сборки мусора. Дашборд не показывает причину проблемы напрямую, но помогает выбрать направление дальнейшей проверки.
Состав дашборда
Глобальные и локальные фильтры
На дашборде доступны следующие элементы управления:
Периодзадает временной диапазон просмотра данныхНодавыбирает узел кластера для анализаВременной интервалзадает шаг отображения временных графиков
Метрики дашборда
Потоковая активность JVM
| Панель | Что показывает | Когда смотреть |
|---|---|---|
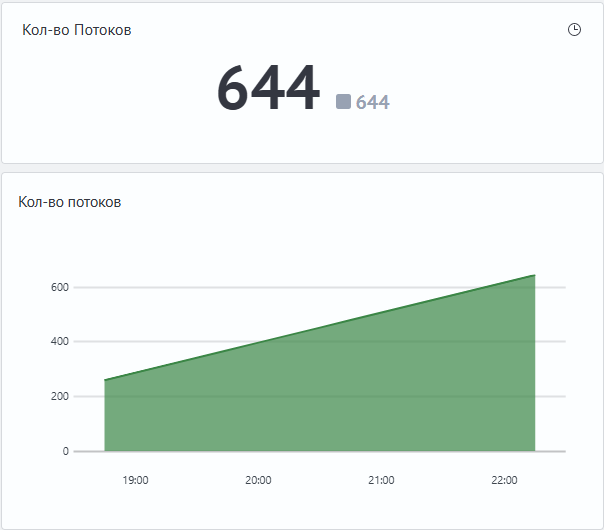
| «Кол-во Потоков» | Общее количество активных потоков JVM на выбранном узле. | При росте задержек, подозрении на зависшие задачи, перегрузку thread pool или неравномерное распределение нагрузки. |
| «Кол-во потоков» | Изменение количества потоков во времени. | Когда нужно понять, был ли рост кратковременным или потоковая активность держится выше обычного уровня. |
Ориентиры штатной работы: значение соответствует обычному диапазону узла и возвращается к нему после пиков нагрузки или операций обслуживания.
Когда нужна дополнительная информация: устойчивый рост без изменения роли, конфигурации или нагрузки.
Общий счетчик потоков не раскрывает состояние потоков, их имена, назначение, принадлежность к конкретному thread pool, размер очередей и число отказов. Поэтому рост этой метрики следует рассматривать как признак для дальнейшей проверки, а не как самостоятельное объяснение причины.
Сравнивать корректнее узлы с одинаковыми ролями, близкой конфигурацией и сопоставимой нагрузкой. В некоторых архитектурах ожидается, что master-узлы имеют меньше потоков, чем data-узлы, а в hot-warm-cold схеме потоковая активность снижается от hot к cold. Эти соотношения не являются универсальными порогами: на них влияют роли, плагины, версия, операции обслуживания и профиль нагрузки.
Память JVM и direct buffer
| Панель | Что показывает | Когда смотреть | Ориентиры штатной работы | Когда нужна дополнительная проверка |
|---|---|---|---|---|
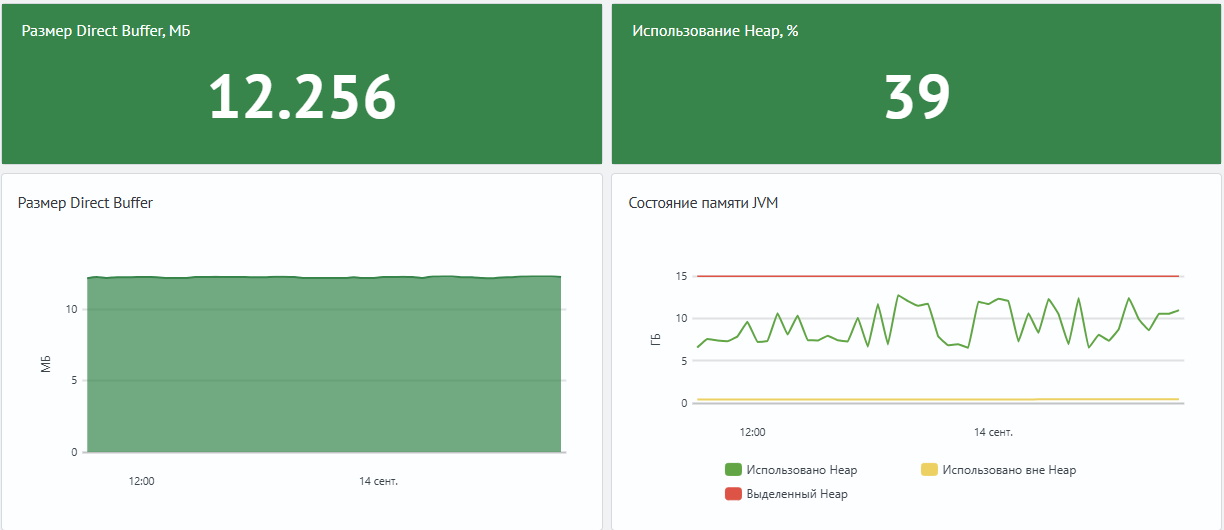
| «Использование Heap, %» | Долю занятого heap на выбранном узле. | При росте потребления памяти, увеличении времени GC, ошибках обработки запросов или подозрении на нехватку памяти. | После циклов GC используемый heap возвращается к обычному диапазону, сохраняется запас до выделенного объема. | Рост нижней границы используемого heap вместе с увеличением времени GC может быть признаком утечки памяти. |
| «Размер Direct Buffer, МБ» | Объем памяти, занятый direct buffer вне Java heap. | При росте сетевой или файловой активности, большом числе соединений, snapshot, восстановлении или перемещении данных. | Потребление меняется вместе с сетевыми и файловыми операциями и стабилизируется после их завершения. | Продолжительный рост стоит сопоставить с соединениями, вводом-выводом, восстановлением и памятью процесса. |
| «Размер Direct Buffer» | Изменение потребления direct buffer во времени. | Когда нужно понять, был ли рост временным или память вне heap продолжает удерживаться. | - | - |
| «Состояние памяти JVM» | Динамику используемого heap, используемой non-heap памяти и выделенного JVM объема heap. | При проверке давления на память, роста рабочего набора, влияния кешей, тяжелых агрегаций и поведения после GC. | Heap имеет циклический профиль, а non-heap стабилизируется после запуска JVM. | Рост минимального уровня heap после GC или продолжительный рост non-heap стоит сопоставить с GC, нагрузкой и памятью процесса на уровне ОС. |
Heap используется для объектов приложения. Non-heap включает служебные области JVM, например метаданные классов и кеш скомпилированного кода. Direct buffer относится к памяти вне Java heap и часто связан с сетевым или файловым вводом-выводом.
Высокое значение heap или рост direct buffer не доказывают утечку. Такие признаки нужно сопоставлять с нагрузкой, журналами, операциями кластера и соседними дашбордами.
Производительность сборщика мусора
| Панель | Что показывает | Когда смотреть | Ориентиры штатной работы | Когда нужна дополнительная проверка |
|---|---|---|---|---|
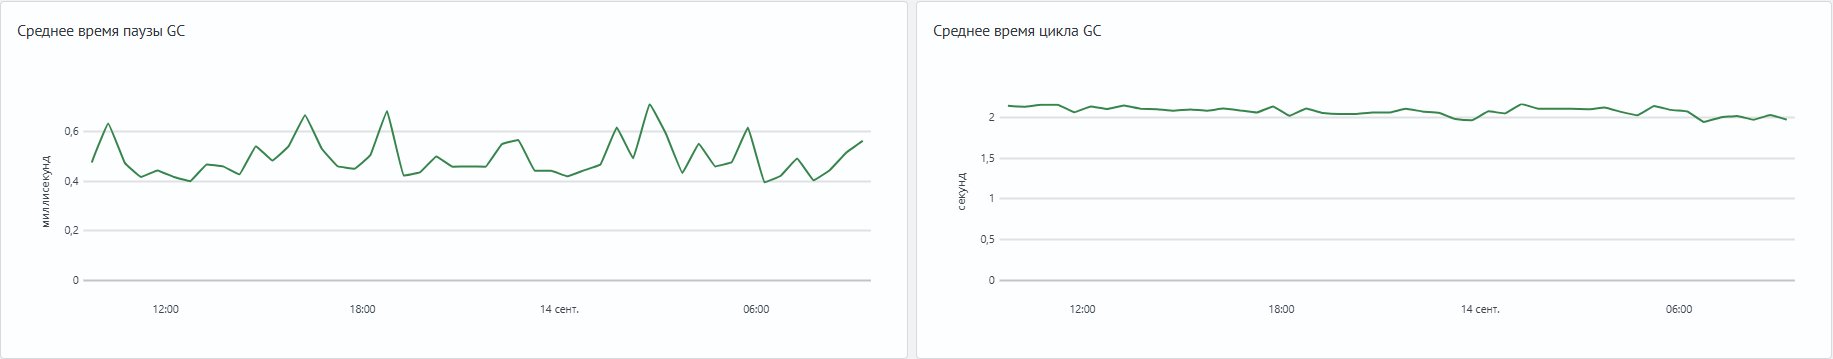
| «Среднее время паузы GC» | Расчетное среднее время пауз GC за выбранный интервал отображения. | При росте задержек, жалобах на нестабильную обработку запросов или высоком использовании heap. | Значение сопоставимо с обычным профилем узла и не совпадает с ростом задержки запросов. | Продолжительный рост стоит проверять вместе с частотой GC, heap, задержкой и пропускной способностью. |
| «Среднее время цикла GC» | Расчетное среднее время цикла сборки мусора. | Когда нужно оценить, меняется ли длительность работы сборщика мусора вместе с нагрузкой и потреблением памяти. | Длительность цикла остается сопоставимой при аналогичной нагрузке. | Рост стоит сопоставить с использованием heap, нагрузкой и событиями в GC-журналах. |
Среднее время цикла GC не следует приравнивать к паузе приложения. Для сборщиков с конкурентными фазами значительная часть цикла может выполняться параллельно с приложением. Тип сборки, ее фазы и причины длительных пауз нужно уточнять по GC-журналам.
Примеры диагностики проблем
Где искать подробности
| Признак или отклонение | Где смотреть подробности |
|---|---|
| Рост количества потоков | «Мониторинг ресурсов ноды»: активные потоки, очереди, отказы и общее число задач по thread pool |
Высокое использование heap или рост времени GC | Поисковая и индексирующая нагрузка, количество и размеры шардов, число сегментов, количество полей в маппингах, GC-журналы и при необходимости heap dump |
Рост direct buffer | «Мониторинг ресурсов ноды», сетевые соединения, дисковый ввод-вывод, операции snapshot и восстановления |
Отличие master, data, hot, warm или cold узлов по потокам | Текущий дашборд, «Мониторинг ресурсов ноды», распределение ролей и шард |
| Рост задержек без явного давления на память | «Мониторинг производительности запросов», «Число запросов в кластере по типу» |
Первичная оценка состояния JVM
Начинайте проверку с общего признака: выросло количество потоков, увеличилось использование heap, вырос direct buffer или появились длительные паузы GC. Эти признаки помогают выбрать направление диагностики, но не являются самостоятельной причиной инцидента.
Если растет heap, сначала сопоставьте график памяти с панелями GC и нагрузкой за тот же период. Если растет количество потоков при стабильной памяти, переходите к метрикам thread pool. Если растет direct buffer, проверьте ввод-вывод, соединения и операции обслуживания данных.
Анализ потоковой активности
График «Кол-во потоков» используйте для проверки динамики. Кратковременный рост может сопровождать пик нагрузки или операции обслуживания кластера. Более важны длительное удержание выше обычного уровня, ступенчатый рост и отличие от узлов той же роли.
Для уточнения причины переходите к дашборду «Мониторинг ресурсов ноды». Там нужно смотреть активные задачи, очереди, отказы и общее число задач по конкретным thread pool, например search, write, management, snapshot и merge.
Анализ памяти JVM
График «Состояние памяти JVM» используйте вместе с индикатором «Использование Heap, %». Если занятая память растет вместе со временем GC, это может указывать на давление на heap. Причину нужно подтверждать дополнительными данными: нагрузкой, журналами JVM, GC-журналами и при необходимости heap dump.
Графики heap и non-heap не показывают классы объектов и удерживающие ссылки. Поэтому по ним нельзя доказать утечку памяти, но можно определить период и узел для детального анализа.
Давление на heap может быть связано с прикладной нагрузкой, конфигурацией шардов и маппингами индексов. Последовательность дальнейшей проверки приведена в разделе «Диагностика нагрузки по heap и GC».
Анализ direct buffer
Панели «Размер Direct Buffer, МБ» и «Размер Direct Buffer» помогают увидеть потребление памяти вне Java heap. Рост этой метрики стоит сопоставлять с сетевой активностью, файловым вводом-выводом, числом соединений, snapshot, восстановлением и перемещением шард.
По одной панели нельзя определить владельца буферов или подтвердить утечку вне heap. Если рост устойчивый, проверьте смежные метрики ресурсов узла и журналы за тот же период.
Анализ GC
Панели «Среднее время паузы GC» и «Среднее время цикла GC» используйте вместе с графиком памяти и метриками нагрузки. Рост пауз важен, если он совпадает с задержками запросов или периодами высокого использования heap.
Диагностика нагрузки по heap и GC
Если рост использования heap совпадает с увеличением времени GC, сначала сопоставьте этот период с поисковой и индексирующей нагрузкой. Проверьте загрузку CPU, задержки запросов, очереди и отказы thread pool. Затем сравните узел с другими узлами той же роли и конфигурации. Отличие одного узла может быть связано с неравномерным размещением шардов или направлением запросов.
Если прикладная нагрузка не объясняет изменение показателей JVM, проверьте количество и размеры шардов, число сегментов и маппинги индексов. При устойчивом росте памяти, которая не освобождается после GC, дополнительно проанализируйте GC-журналы и heap dump.
Проверка овершардинга
Каждый шард является отдельным индексом Lucene и использует память для собственных структур и сегментов. Большое количество небольших шардов увеличивает постоянные накладные расходы на heap и CPU. Поисковые запросы распределяются между большим числом шардов, а операции refresh, merge, восстановление и перемещение выполняются для каждого шарда отдельно.
На возможный овершардинг может указывать сочетание высокого использования heap, увеличения времени GC и умеренной пользовательской нагрузки. Для проверки сопоставьте количество шардов на узлах, размеры первичных шардов и реплик, число сегментов и количество небольших индексов. По текущему дашборду подтвердить овершардинг нельзя.
Если в кластере много небольших шардов:
- скорректируйте шаблоны новых индексов и число первичных шардов с учетом ожидаемого объема данных
- пересмотрите условия
rollover, если новые индексы создаются слишком часто - объедините небольшие индексы с помощью
reindex, если это допускают сроки хранения и схема доступа - для индексов, переведенных в режим только чтения, рассмотрите
shrink - удалите индексы с истекшим сроком хранения
- проверьте необходимое число реплик с учетом требований к отказоустойчивости и поисковой нагрузке
Универсального допустимого количества шардов на узел нет. Оно зависит от объема heap, размеров шардов, числа сегментов и профиля нагрузки. Число первичных шардов существующего индекса нельзя уменьшить обычным изменением настройки: для этого используют новый индекс с последующим reindex либо операцию shrink.
Проверка маппингов индексов
Маппинг с большим количеством полей увеличивает объем метаданных и потребление памяти. При динамическом маппинге документы с переменными ключами могут постоянно создавать новые поля. Это увеличивает нагрузку на JVM и может приводить к более частой работе GC.
Проверьте, в каких индексах содержится наибольшее количество полей и продолжает ли оно расти. Убедитесь, что идентификаторы, даты и другие переменные значения не используются как имена полей. Для данных с предсказуемой структурой используйте явный маппинг и динамические шаблоны. Ненужные поля исключайте на этапе приема данных. Если маппинг существующего индекса требуется изменить, создайте новый индекс и перенесите данные с помощью reindex.
Для JSON-объектов с большим или заранее неизвестным набором ключей можно рассмотреть тип flat_object. Он позволяет хранить объект без создания отдельного поля маппинга для каждого вложенного ключа. Такой вариант подходит, если содержимое объекта в основном нужно получать из документа, а вложенные значения не используются для типизированного поиска, сортировки и агрегаций.
flat_object не является универсальной заменой обычному object. Вложенные значения не получают собственных типов, а возможности работы с ними в запросах ограничены. Перед изменением проверьте запросы, визуализации и отчеты, которые используют эти поля. Если поле не используется вообще, предпочтительнее исключить его на этапе приема данных.
Типовые сценарии
Признаки давления на heap
Сценарий показывает одновременный рост используемого heap и расчетного времени GC.
На дашборде это проявляется так:
- показатель
Использование Heap, %долго показывает высокий уровень использования памяти - на графике
Состояние памяти JVMсерия используемогоheapрастет и приближается к выделенному объему - показатели
Среднее время паузы GCилиСреднее время цикла GCрастут в тот же период
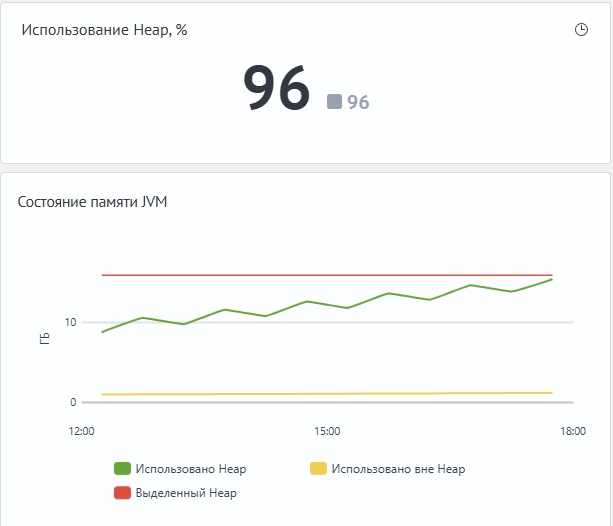
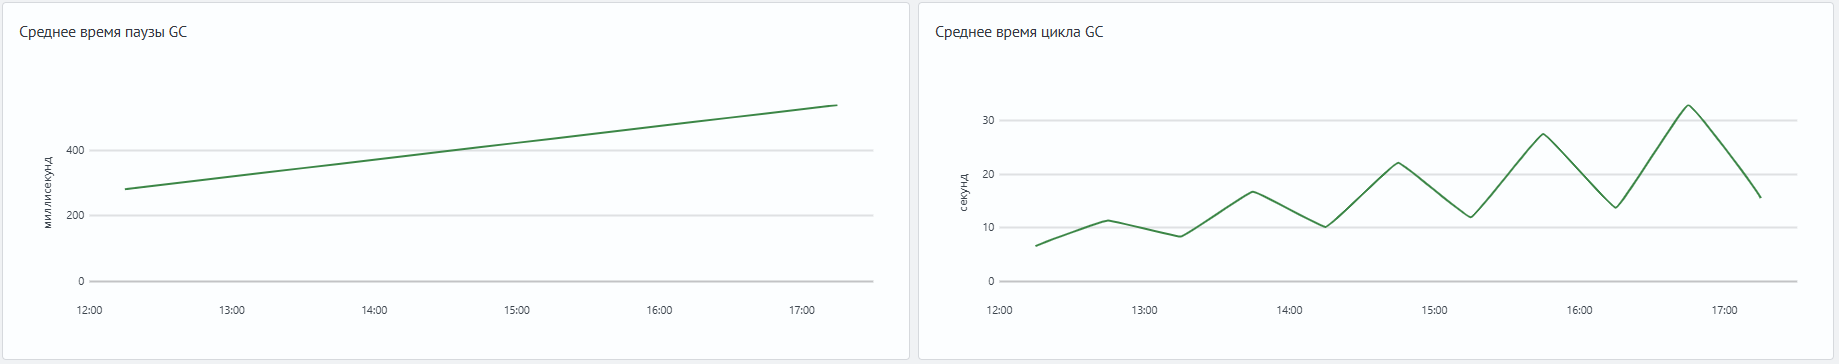
На изображениях используемый heap постепенно приближается к доступному JVM объему, а расчетное время GC увеличивается. Такая картина указывает на рост давления на память.
Для поиска причины используйте порядок из раздела «Диагностика нагрузки по heap и GC»: сначала проверьте прикладную нагрузку, затем конфигурацию шардов и маппингов, после чего при необходимости переходите к GC-журналам и heap dump.
Текущий дашборд не показывает классы объектов и удерживающие ссылки. Для подтверждения утечки памяти нужны дополнительные данные, например heap dump и анализ объектов.
Рост количества потоков на узле
Рост общего количества потоков может сопровождать увеличение нагрузки или операции обслуживания кластера. Проверки требует устойчивое отклонение от обычного уровня, особенно если оно не объясняется известной нагрузкой за тот же период.
На дашборде это проявляется так:
- показатель
Кол-во Потоковпоказывает повышенное значение относительно обычного уровня выбранного узла - график
Кол-во потоковпоказывает рост или длительное удержание повышенного уровня - показатели памяти и
GCмогут оставаться стабильными
На изображении видно, что количество потоков на выбранном узле растет в течение нескольких интервалов и остается выше предыдущего уровня. Такая картина подтверждает рост общего количества активных потоков, но не показывает, какие потоки или пулы дали этот прирост.
Перейдите к дашборду «Мониторинг ресурсов ноды» и проверьте за тот же период активные задачи, очереди, отказы и общее число задач для нужных thread pool. Дополнительно сопоставьте изменение с поиском, индексированием, snapshot, восстановлением, relocation и merge.
Если сравниваются разные роли узлов, учитывайте архитектуру кластера. Для master-узлов обычно ожидается меньшая потоковая нагрузка, чем для data-узлов, а в hot-warm-cold схеме потоковая активность часто снижается от hot к cold. Эти соотношения помогают заметить перекос нагрузки, но итоговый вывод нужно делать по базовой линии узла и смежным метрикам.