Дашборд «Мониторинг производительности индексирования»
Описание статьи
Дашборд используется для анализа производительности индексирования в кластере Smart Monitor. Он показывает операции записи, неудавшиеся индексации, периоды ограничения скорости индексирования, а также внутренние операции индекса: merge, refresh и flush.
Панели помогают найти интервал изменения показателей и определить направление дальнейшей проверки. По одному этому дашборду нельзя установить точную причину ошибок записи, задержек индексирования или перегрузки хранилища: выводы нужно подтверждать журналами, ответами запросов, состоянием шардов и ресурсными метриками узла.
Состав дашборда
Глобальные и локальные фильтры
На дашборде доступны следующие элементы управления:
Периодзадает временной диапазон просмотра данныхНодавыбирает узел кластера для детализацииВременной интервалзадает шаг отображения временных графиков
Метрики дашборда
Оперативное состояние записи

| Панель | Что показывает | Когда смотреть | Ориентиры штатной работы | Когда нужна дополнительная проверка |
|---|---|---|---|---|
| "Неудавшиеся индексации" | Количество операций индексирования, завершившихся ошибкой при записи по схемам Пользователь → индекс и Плагин Smart Monitor → индекс. | При росте счетчика проверьте ответы на запросы индексирования, журналы пользователя или плагина Smart Monitor и состояние целевого индекса. | Счетчик не увеличивается. Стабильное ненулевое значение может относиться к ошибкам, произошедшим ранее. | Любой прирост означает новые неудавшиеся операции. |
| "Индексация в подавлении, секунд" | Время, в течение которого индексирование ограничивалось по скорости. | При росте задержек записи, активных merge/flush-операциях или подозрении на перегрузку тракта записи. | Показатель не растет либо кратковременное ограничение не приводит к нарушению требований к записи. | Продолжительный рост вместе с увеличением времени индексирования или снижением выходного потока может указывать на ограничение тракта записи. |
| "Активных merge" | Количество merge-операций, выполняющихся на узле. | Когда нужно понять, есть ли фоновая активность сегментов, способная конкурировать за ресурсы. | Активность соответствует объему записи и завершается без продолжительного ухудшения индексирования и поиска. | Рост стоит проверять, если он совпадает с увеличением нагрузки на дисковую подсистему, потребления памяти, времени индексирования или длины очередей. |
| "Merge использует памяти, МБ" | Объем памяти, занятый merge-операциями. | При высокой активности merge, росте потребления памяти или деградации операций записи. | - | - |
Поток и задержка индексирования

| Панель | Что показывает | Когда смотреть | Ориентиры штатной работы | Когда нужна дополнительная проверка |
|---|---|---|---|---|
| "Количество индексаций" | Объем выполненных кластером операций индексирования и связанные временные затраты. | При оценке динамики индексирования и сравнении ее со скоростью поступления событий за тот же период. | Кластер обрабатывает входящий поток без накопления отставания. | Скорость индексирования устойчиво ниже скорости поступления событий либо время обработки растет при сопоставимой нагрузке. |
| "Среднее время индексации документа" | Расчетную длительность одной операции индексирования. | При росте задержек записи. Показатель нужно сопоставлять с количеством операций, размером документов, throttling и ресурсами узла. | Значение соответствует требованиям к записи и обычному профилю документов при сопоставимой нагрузке. | Устойчивый рост стоит сопоставить с размером документов, очередями, состоянием шардов. Среднее значение может скрывать отдельные медленные операции. |
Ошибки и throttling во времени
| Панель | Что показывает | Когда смотреть |
|---|---|---|
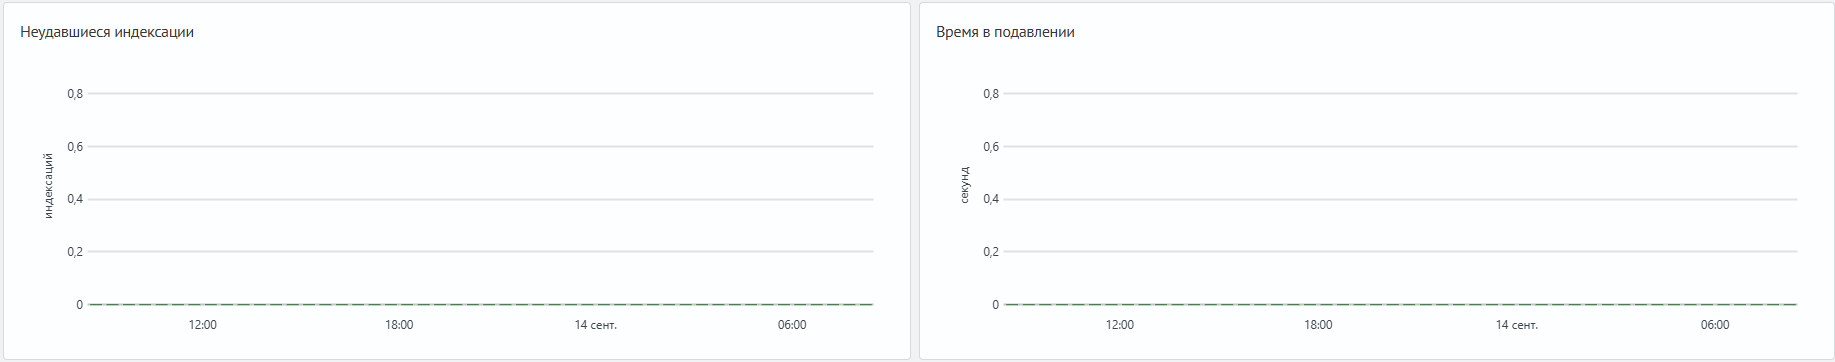
| "Неудавшиеся индексации" | Распределение во времени ошибок индексирования. | Когда нужно определить интервал ошибки и проверить ответы на запросы индексирования, журналы инициатора и состояние целевого индекса. |
| "Время в подавлении" | Распределение периодов throttling во времени. | Когда нужно понять, в какие интервалы узел ограничивал индексирование, и сопоставить их с ресурсами и внутренними операциями. |
Внутренние операции индекса
| Панель | Что показывает | Когда смотреть |
|---|---|---|
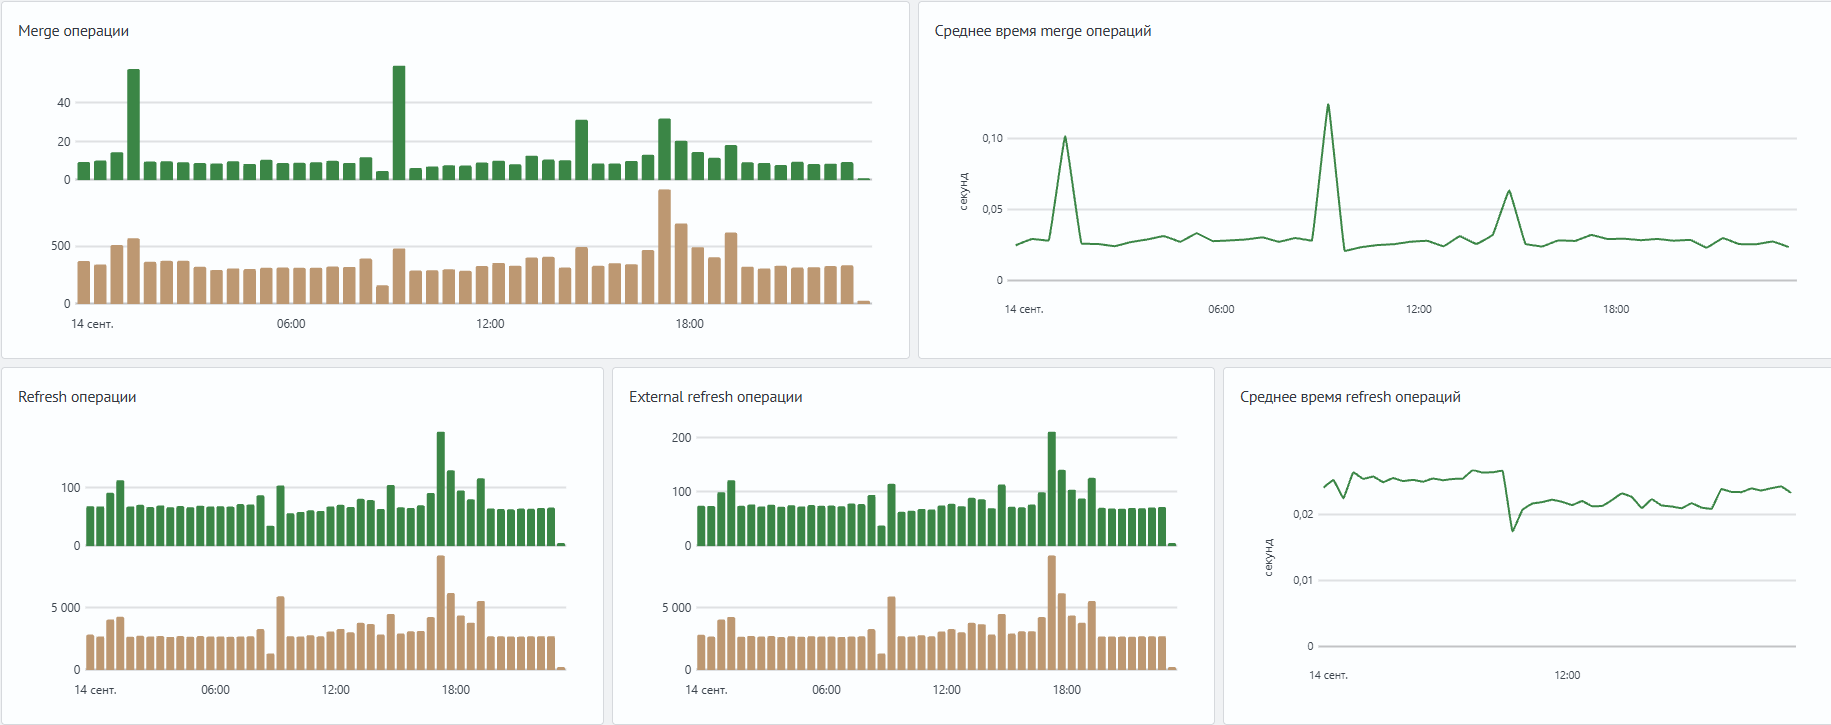
| "Merge операции" | Количество и длительность операций слияния сегментов. | При росте задержек записи, активности фоновых операций или подозрении на конкуренцию за ресурсы диска. |
| "Среднее время merge операций" | Расчетную длительность одной merge-операции. | Когда нужно оценить тренд длительности merge и сопоставить его с записью, поиском и хранилищем. |
| "Refresh операции" | Операции, после которых недавно проиндексированные документы становятся видимыми для поиска. | При задержке видимости данных в поиске, росте числа мелких сегментов или высокой поисковой нагрузке. |
| "External refresh операции" | Отдельный класс refresh-операций, который источник метрик относит к external, если такая панель есть в дашборде. | Когда нужно проверить, не связана ли нагрузка с частыми запросами немедленной видимости данных. |
| "Среднее время refresh операций" | Расчетную длительность refresh-операции. | При росте задержки видимости данных, поисковой нагрузке или изменениях режима записи. |
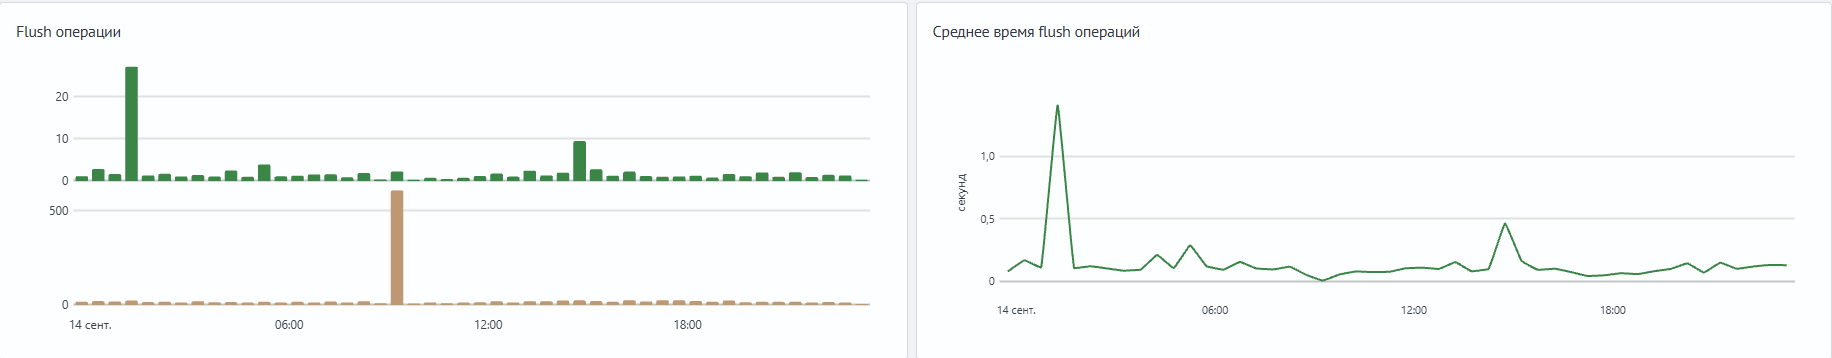
| "Flush операции" | Операции фиксации изменений и обслуживания translog. | При проверке влияния записи, fsync, заполненности диска и merge-операций. |
| "Среднее время flush операций" | Расчетную длительность одной flush-операции. | При устойчивом росте времени записи или признаках проблем с хранилищем. |
Примеры диагностики проблем
Где искать подробности
| Признак или отклонение | Где смотреть подробности |
|---|---|
| Рост неудавшихся индексаций | ответы на запросы индексирования, журналы пользователя или плагина Smart Monitor, состояние целевого индекса, «Состояние кластера» |
| Рост времени throttling | «Мониторинг ресурсов ноды», блоки merge/flush текущего дашборда |
| Рост среднего времени индексирования | текущий дашборд, «Мониторинг ресурсов ноды», «Мониторинг Logstash» |
| Ошибки записи вместе с изменением статуса кластера | «Состояние кластера» |
| Заполнение диска или проблемы размещения шардов | «Состояние кластера», «Мониторинг ресурсов ноды» |
| Признаки проблем ingest-потока | «Мониторинг Logstash», «Мониторинг JVM ноды Logstash» |
Первичная оценка индексирования
Начинайте проверку с верхних индикаторов: есть ли неудавшиеся индексации, накапливается ли время ограничения индексирования и выполняются ли активные merge-операции. Эти признаки помогают выбрать направление диагностики, но не являются самостоятельным объяснением причины.
Если растет счетчик неудавшихся индексаций, определите инициатора операции и проверьте ответы запросов записи, журналы пользователя или плагина Smart Monitor, состояние целевого индекса и шардов. Если ошибок нет, но растут время throttling и задержка индексирования, переходите к анализу внутренних операций индекса и ресурсных метрик узла.
Анализ ошибок индексирования
В контексте этого дашборда неудавшаяся индексация означает ошибку операции записи по схеме Пользователь → индекс или Плагин SM → индекс. Панель показывает факт и время роста счетчика, но не содержит причину ошибки. Ее нужно искать в ответах операций записи, журналах инициатора и состоянии целевого индекса за тот же период.
Типовые направления проверки:
- данные и mapping: документ может не соответствовать схеме индекса: неверный тип поля, некорректная дата, ошибка парсинга или конфликт шаблона
- ingest pipeline: ошибка может возникать на этапе преобразования документа: разбор JSON, date parsing, grok-шаблон, обязательные поля или пользовательская логика
- состояние шардов: запись может завершаться ошибкой, если недоступен нужный primary shard, индекс закрыт или есть ограничения размещения
- ограничения кластера: проверяйте блокировки индекса, дисковые ограничения, circuit breaker и отклонения задач в пулах записи
Анализ задержек и throttling
Throttling показывает, что индексирование ограничивалось по скорости. Этот показатель не равен количеству ошибок и не объясняет причину ограничения. Его нужно сопоставлять с количеством операций индексирования, средним временем обработки, активностью merge, временем flush и ресурсами узла.
Если throttling растет без роста ошибок, это больше похоже на замедление обработки, чем на отказ записи. Если throttling совпадает с ошибками, проверьте, не исчерпываются ли ресурсы узла и не появляются ли отклонения задач в пулах записи.
Анализ внутренних операций merge, refresh, flush
Merge объединяет сегменты индекса. Операция читает существующие сегменты и записывает новые, поэтому при высокой активности может конкурировать за ресурсы с индексированием, поиском и flush. Длительный merge не всегда является ошибкой: его нужно оценивать по тренду и в связке с нагрузкой на узел.
Во время refresh движок делает недавно проиндексированные документы видимыми для поиска. Это near real-time операция: документ может быть успешно принят индексированием раньше, чем станет доступен поисковым запросам.
Refresh не следует смешивать с flush. Refresh обновляет поисковое представление индекса и отвечает за видимость данных в поиске. Flush относится к фиксации изменений и обслуживанию translog.
Если дашборд разделяет общие и external refresh-операции, используйте это как дополнительный сигнал. Частый рост external refresh может быть связан с запросами немедленной видимости данных, но без логов, трассировки или данных приложения нельзя определить конкретного инициатора.
Рост времени flush следует сопоставлять с записью, fsync, заполненностью хранилища и активностью merge.
Типовые сценарии
Рост неудавшихся индексаций
Сценарий возникает, когда счетчик неудавшихся индексаций увеличивается в рассматриваемом интервале.
На дашборде это проявляется так:
- счетчик
Неудавшиеся индексацииувеличивается в рассматриваемом интервале - на графике
Неудавшиеся индексациивиден интервал роста ошибок - панель
Количество индексацийможет показывать, что операции записи продолжают выполняться - панели
Время в подавлении,Среднее время flush операцийиСреднее время merge операцийдают дополнительный контекст, но не определяют причину ошибок без логов и ответов запросов
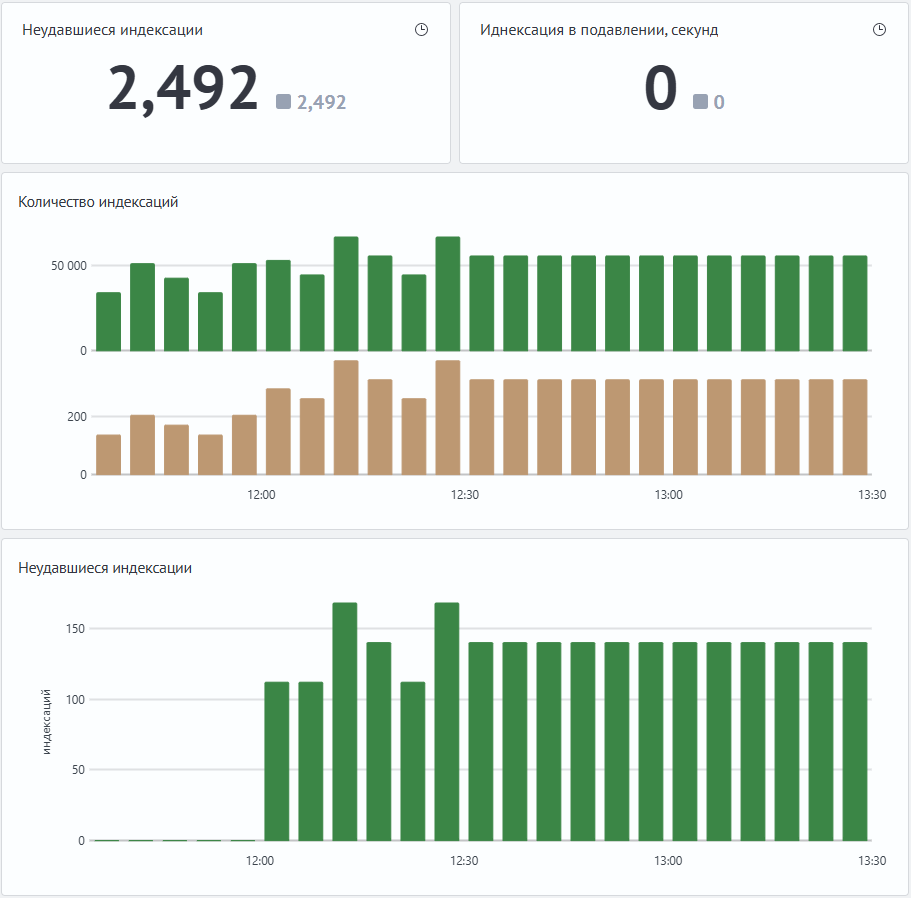
На примере виден рост неудавшихся операций индексирования при отсутствии одновременного роста времени throttling. Это помогает отделить факт ошибки записи от ограничения скорости индексирования, но не определяет причину сбоя. Для диагностики нужно проверить ответы bulk/index, состояние шардов и связанные ошибки на стороне кластера.
Косвенные признаки перегрузки тракта записи
Сценарий возникает, когда дашборд показывает признаки замедления индексирования: растет время throttling, увеличивается среднее время обработки или одновременно активны фоновые операции индекса. Эти признаки указывают направление проверки, но не подтверждают конкретную причину без ресурсных метрик и состояния кластера.
На дашборде это проявляется так:
- показатели
Индексация в подавлении, секундиВремя в подавлениипоказывают ненулевые значения - показатель
Среднее время flush операцийустойчиво растет - показатель
Среднее время индексации документарастет при сопоставимом количестве операций индексирования - показатели
Среднее время merge операций,Активных mergeиMerge использует памяти, МБпоказывают активность фонового слияния сегментов

На примере видны ненулевое время throttling и активность merge-операций. Такая картина указывает направление дальнейшей проверки, но требует подтверждения по ресурсным метрикам и состоянию кластера.
При таких признаках перейдите к дашборду «Мониторинг ресурсов ноды» и сопоставьте их с графиками чтения, записи, заполненности хранилища и очередей. Если есть признаки заполнения диска, проверьте состояние шардов и логику дисковых ограничений в статье «Состояние кластера».