Дашборд «Мониторинг JVM ноды Logstash»
Описание статьи
Дашборд используется для анализа состояния процесса JVM Logstash на выбранном узле. Он показывает использование памяти heap и non-heap, количество активных потоков JVM и время работы сборщика мусора.
Панели помогают обнаружить признаки давления на память, рост потоковой активности и возможное влияние GC на обработку событий. Дашборд показывает симптомы и направление дальнейшей проверки, но не заменяет анализ журналов Logstash, состояния pipeline, очередей и внешних систем, в которые Logstash передает данные.
Состав дашборда
Глобальные и локальные фильтры
На дашборде доступны элементы управления для выбора периода просмотра, узла Logstash и детализации временных рядов.
Timeограничивает временной диапазон анализаНодапозволяет сфокусироваться на конкретном узле LogstashВременной интервалуправляет детализацией графиков во времени
Метрики дашборда
Ниже приведены основные группы панелей.

Верхние индикаторы состояния JVM
Верхние индикаторы используются для быстрой первичной оценки выбранного узла. Они помогают понять, какое направление проверять первым: потоков, памяти или GC.
| Панель | Что показывает | Ориентиры штатной работы | Когда нужна дополнительная проверка |
|---|---|---|---|
| «Кол-во Потоков» | Текущее количество активных потоков JVM. | Значение сопоставимо с обычным уровнем узла с учетом состава pipeline и используемых плагинов. | Устойчивое изменение без заметного роста нагрузки или изменения конфигурации стоит сопоставить с CPU, задержкой, backpressure и ошибками создания потоков. Только по количеству потоков нельзя определить наличие проблемы. |
| «Использование Heap, %» | Текущую долю занятой heap-памяти JVM. | После пиков и циклов GC занятая память возвращается к обычному уровню, а между используемым и доступным heap сохраняется запас. | На сокращение запаса или постепенный рост минимального уровня памяти после GC стоит обратить внимание. Если одновременно увеличивается длительность Old GC, снижается пропускная способность, накапливается очередь или возникают OutOfMemoryError и перезапуски, необходима более подробная проверка. |
Динамика потоков и памяти
| Панель | Что показывает | Ориентиры штатной работы | Когда нужна дополнительная проверка |
|---|---|---|---|
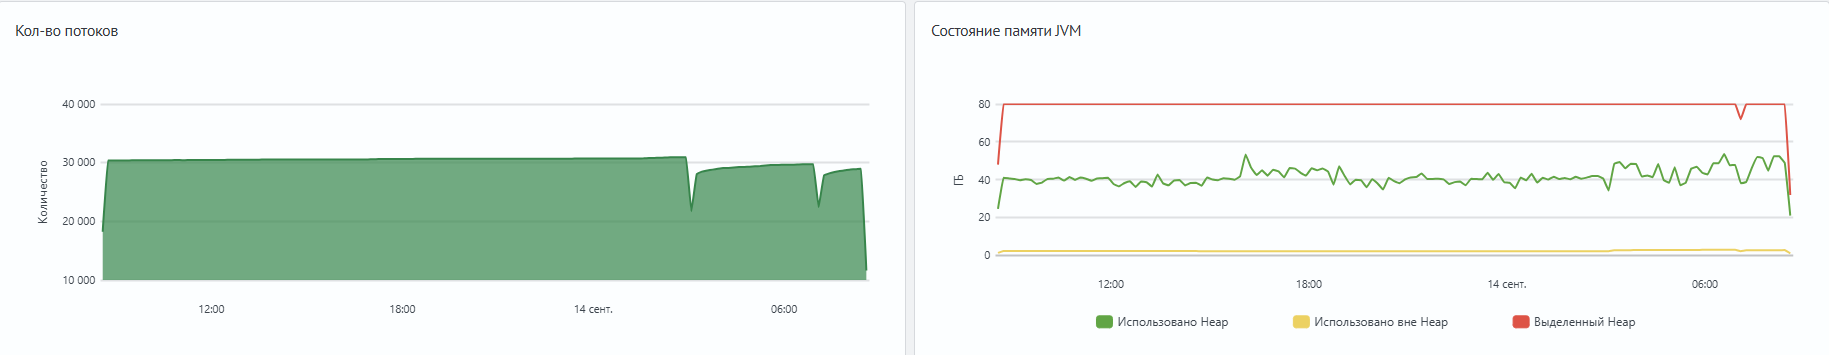
| «Кол-во потоков» | Изменение количества активных потоков JVM во времени. | Количество потоков меняется вслед за нагрузкой и возвращается к привычному диапазону. Новый стабильный уровень после изменения конфигурации также может быть штатным. | Устойчивый рост при сопоставимой нагрузке стоит проверить вместе с CPU, переключениями контекста, задержками pipeline и backpressure. Ошибка unable to create native thread указывает на невозможность JVM создать новый поток и требует отдельной диагностики ресурсов процесса и ОС. |
| «Состояние памяти JVM» | Соотношение занятого heap, выделенного heap и используемой non-heap памяти. | Heap имеет циклический профиль и освобождается после GC; non-heap обычно стабилизируется после запуска и прогрева JVM. | Устойчивый рост нижней границы используемого heap после GC или продолжительный рост non-heap может быть поводом для проверки. Возможное влияние оценивают по времени GC, пропускной способности, ошибкам выделения памяти и состоянию процесса на уровне ОС или контейнера. |
В панели «Состояние памяти JVM» обычно используются следующие серии:
- «Использовано Heap» - объем
heap, занятый объектами JVM. - «Выделенный Heap» - объем
heap, доступный JVM на момент измерения. Эта серия не обязательно равна настроенному максимальному размеруheap. - «Использовано вне Heap» - используемая
non-heapпамять JVM, включая области вроде Metaspace и Code Cache.
Non-Heap не равен всей памяти процесса Logstash вне heap. Если расход памяти на уровне ОС или контейнера растет, а heap и non-heap выглядят стабильными, дополнительно проверяются native memory, direct buffers, mmap, файловые операции и ограничения среды выполнения.
Производительность сборщика мусора
| Панель | Что показывает | Ориентиры штатной работы | Когда нужна дополнительная проверка |
|---|---|---|---|
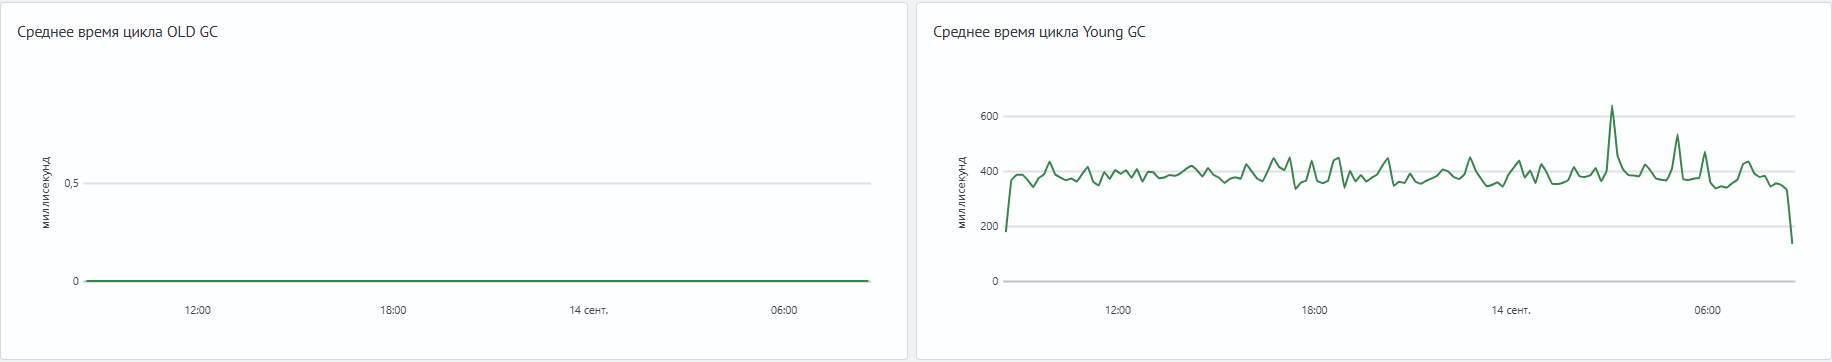
| «Среднее время цикла OLD GC» | Среднюю длительность работы сборщика мусора старшего поколения. | Отдельные циклы не сопровождаются продолжительным ростом занятого heap, очереди и задержки обработки. | Повторяющийся рост длительности вместе с повышением нижней границы heap может быть признаком утечки памяти. Возможное влияние стоит проверять по паузам обработки, пропускной способности, состоянию очереди и наличию OutOfMemoryError или перезапусков. |
| «Среднее время цикла Young GC» | Среднюю длительность работы сборщика мусора младшего поколения. | Значение остается сопоставимым с обычным уровнем при аналогичной нагрузке, а скорость обработки событий заметно не меняется. | Рост стоит проверить, если он сохраняется при сопоставимой нагрузке или совпадает с падением пропускной способности и ростом очереди. Одной из возможных причин может быть увеличение скорости создания краткоживущих объектов. |
Рост времени Young GC чаще связан с интенсивным созданием краткоживущих объектов. Рост времени Old GC требует большего внимания: он может указывать на утечку памяти, удержание крупных объектов, очереди, retry/backoff в output-плагинах или недостаточный запас heap.
Примеры диагностики проблем
Где искать подробности
| Признак или отклонение | Где смотреть подробности |
|---|---|
Рост использования heap или подозрение на удержание объектов | Текущий дашборд, логи Logstash, конфигурация pipeline, настройки очередей и batch-обработки |
| Рост времени Young GC | Текущий дашборд, «Мониторинг Logstash», конфигурация фильтров и объем входящих событий |
| Рост времени Old GC | Текущий дашборд, логи Logstash, очереди, output-плагины и внешние системы-получатели |
| Рост количества потоков JVM | «Мониторинг Logstash», таблица Hot Threads, логи и метрики CPU |
| Рост памяти процесса на уровне ОС или контейнера | «Мониторинг ресурсов ноды», метрики контейнера, native memory и direct buffers |
| Проблемы сбора данных или задержки передачи данных | «Мониторинг Logstash», текущий дашборд, состояние получателя данных |
Первичная оценка состояния JVM Logstash
Начинайте проверку с верхних индикаторов: использования heap и количества активных потоков. Если один из показателей выделяется, переходите к графикам динамики и проверяйте, является ли изменение кратковременным всплеском или устойчивым трендом.
Если одновременно растут использование heap и время Old GC, сначала проверьте признаки давления на память. Если растет количество потоков без заметного роста heap, вероятнее проблема связана с нагрузкой, ожиданием внешних систем, блокировками или настройками pipeline. Если сильнее выделяется Young GC, проверьте профиль обработки событий и фильтры, которые создают много временных объектов.
Анализ использования памяти
Память JVM нужно оценивать по нескольким метрикам одновременно. Серия «Использовано Heap» показывает, сколько памяти занято объектами. Серия «Выделенный Heap» показывает объем heap, доступный JVM в момент измерения, но не является прямым отображением максимального лимита. Серия «Использовано вне Heap» описывает JVM-память вне heap, но не покрывает всю память процесса на уровне ОС.
Похожая картина может возникать при удержании объектов, увеличении нагрузки, накоплении очереди или задержках внешней системы-получателя.
Анализ количества потоков
Количество потоков JVM является косвенным признаком. Рост значения показывает изменение потоковой активности, но по этой метрике нельзя определить состояние потоков, конкретный pipeline, блокировку или зависшую операцию.
Если количество потоков растет вместе с задержками обработки, проверьте логи, CPU, состояние pipeline, input и output-плагины. Для анализа конкретных горячих потоков используется дашборд «Мониторинг Logstash», а не текущий JVM-дашборд.
Анализ работы GC
Метрики Young GC и Old GC нужно рассматривать вместе с heap и нагрузкой на Logstash. Рост времени Young GC чаще говорит о высокой скорости создания временных объектов. Рост времени Old GC может указывать на утечку памяти и требует проверки объектов, которые живут дольше одного цикла обработки.
Если Young GC растет, но heap возвращается к обычному диапазону, причина может быть в профиле аллокаций или временном пике нагрузки. Если растут Old GC и использование heap не возвращается к прежнему уровню, сценарий требует проверки на устойчивое удержание объектов.
Типовые сценарии
Признаки возможного устойчивого роста heap
Дашборд помогает заметить устойчивый рост использования heap, но не подтверждает утечку памяти сам по себе. Устойчивый рост может быть связан с удержанием объектов, увеличением нагрузки, накоплением событий в очереди, поведением плагинов или задержками внешней системы-получателя.
На дашборде это проявляется так:
- «Использование Heap, %» остается повышенным или растет после завершения нагрузки.
- «Использовано Heap» не возвращается к обычному диапазону и продолжает смещаться вверх.
- «Выделенный Heap» остается близко к используемому объему, поэтому запас внутри доступного
heapуменьшается. - «Среднее время цикла OLD GC» растет вместе с использованием
heap, что может указывать на утечку памяти. - «Кол-во потоков» может оставаться стабильным. Это означает только то, что рост памяти не сопровождается ростом общего количества активных потоков JVM.
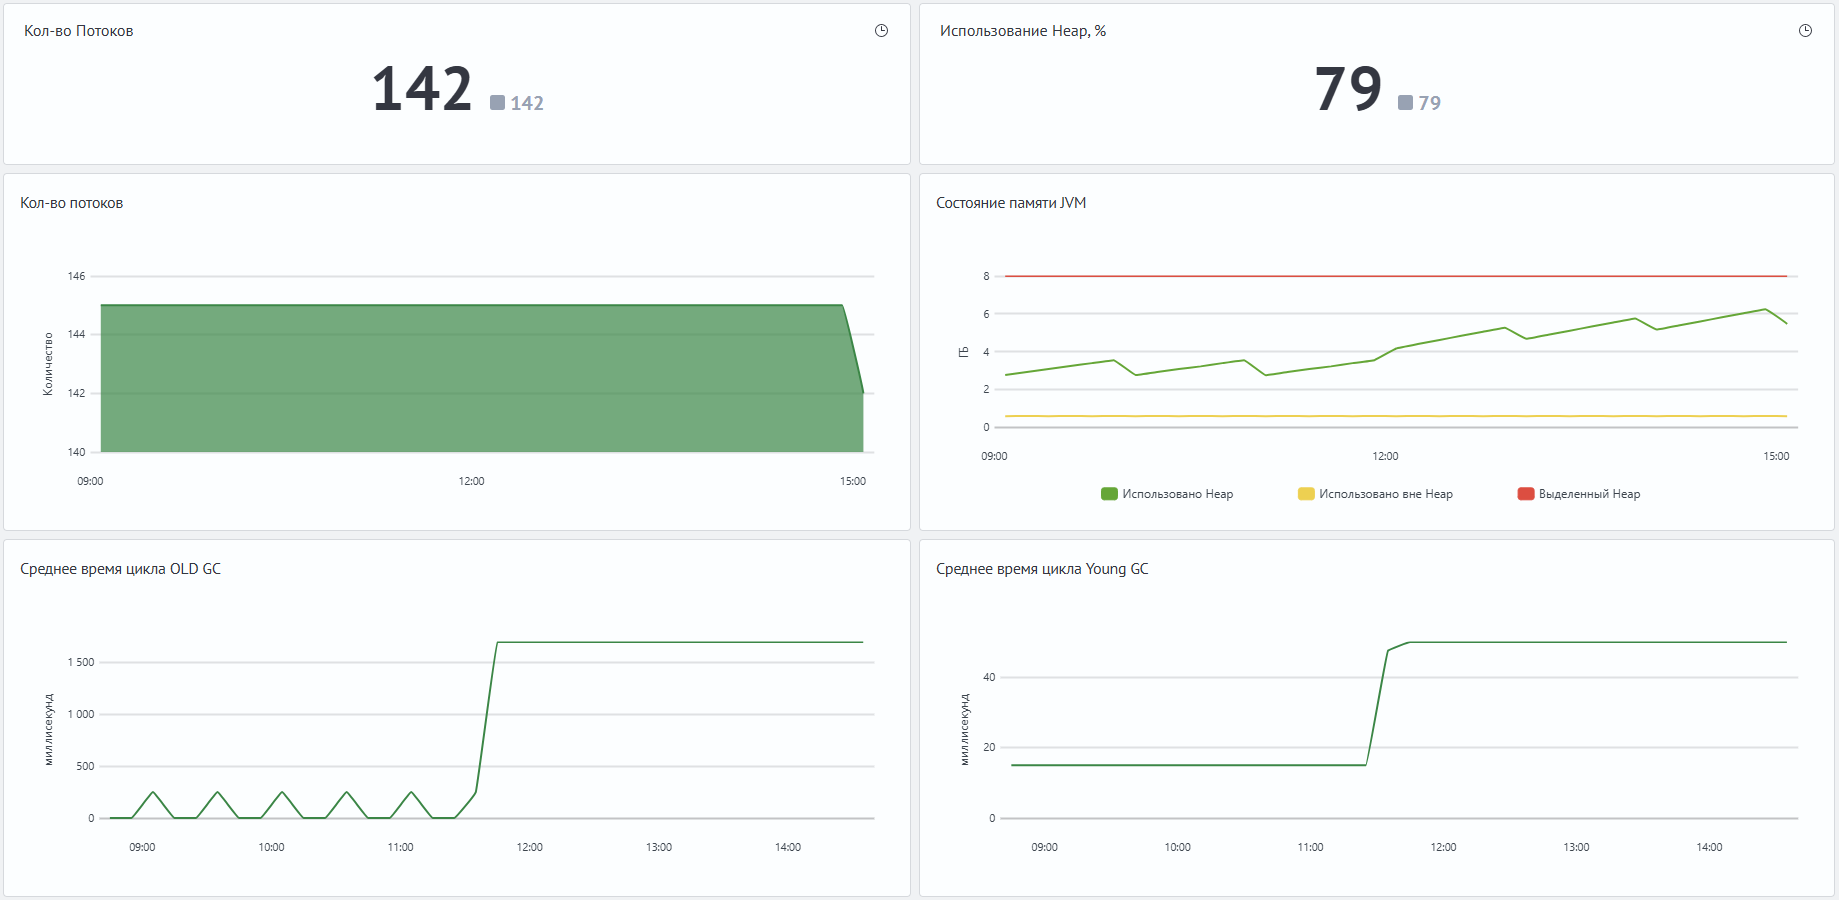
На изображении видно, что использование heap поднялось до 79%, а линия «Использовано Heap» постепенно растет при почти неизменной линии «Выделенный Heap». Одновременно расчетное среднее время Old GC скачком увеличилось примерно до 1,7 секунды, а Young GC — примерно до 50 мс. Такая комбинация указывает на давление на память JVM: Logstash продолжает работать, но увеличение времени работы сборщика мусора может влиять на обработку событий.
В такой ситуации нужно проверить конфигурацию pipeline, фильтры, output-плагины, очереди, размер обрабатываемых событий и ошибки записи во внешнюю систему. Для подтверждения именно утечки потребуется отдельный анализ памяти вне этого дашборда.
Рост среднего времени циклов Young GC и Old GC
Сценарий возникает, когда JVM начинает тратить больше времени на работу сборщика мусора. Для Logstash это может быть связано как с нормальным ростом нагрузки, так и с тяжелой обработкой событий, большим количеством временных объектов или удержанием данных в памяти.
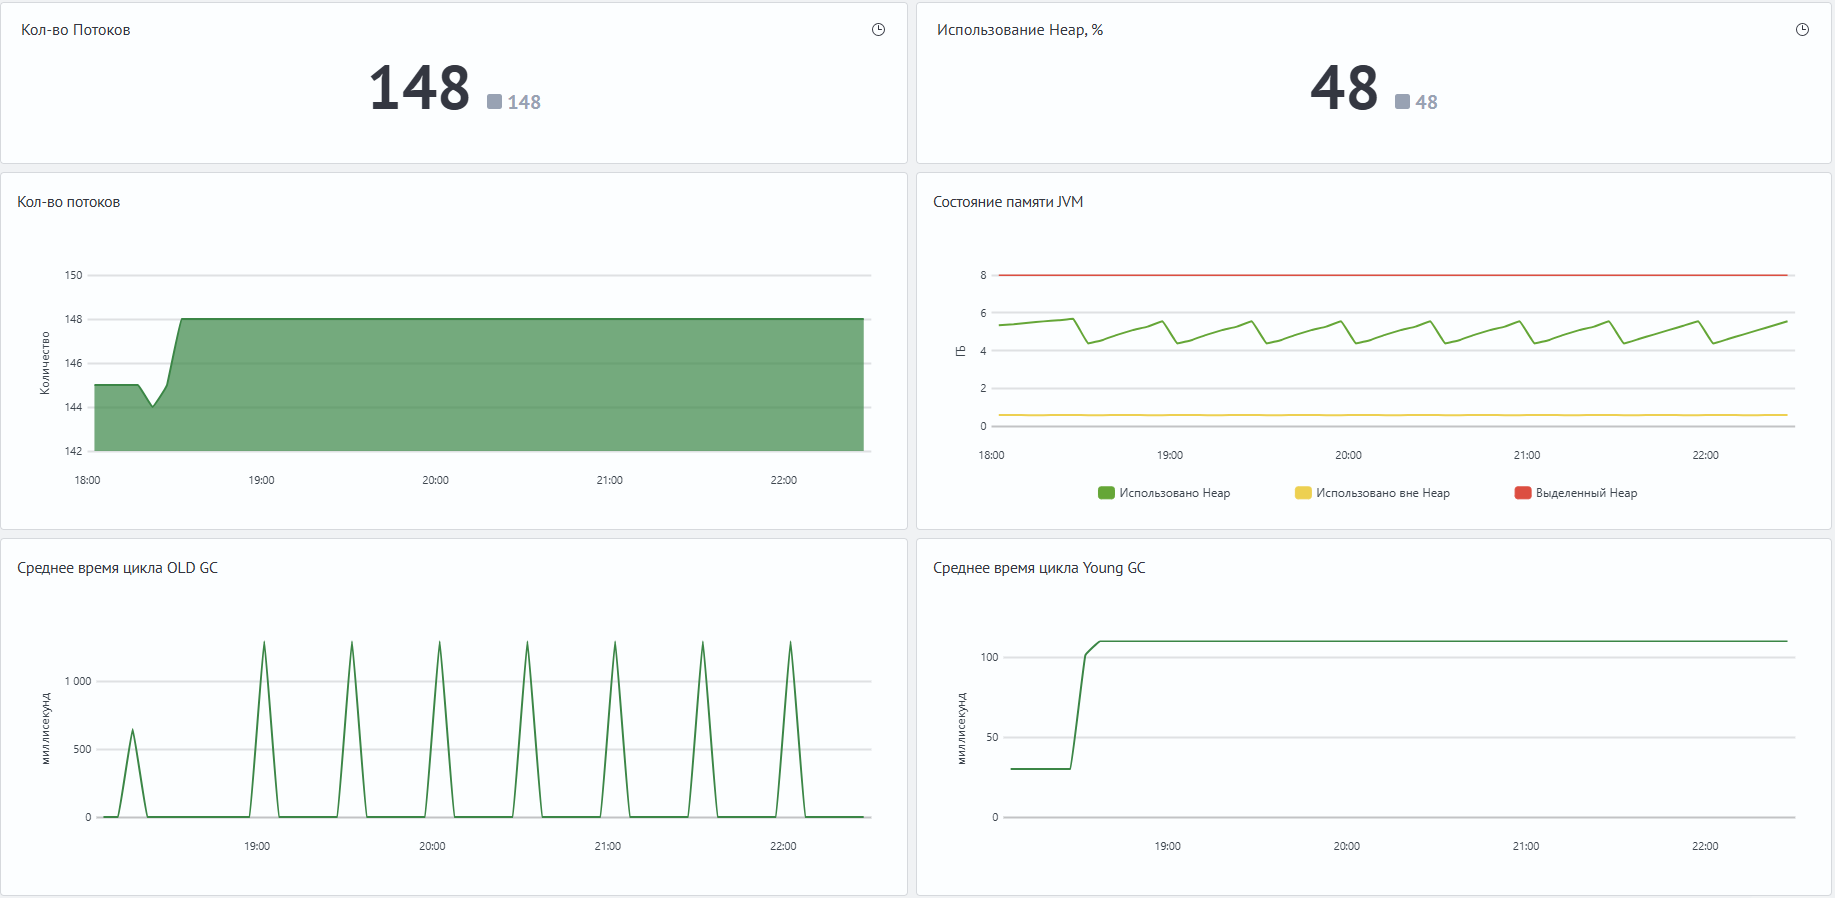
На дашборде это проявляется так:
- «Среднее время цикла Young GC» растет при интенсивном создании краткоживущих объектов.
- «Среднее время цикла OLD GC» показывает заметные пики или устойчивый рост при утечке памяти.
- «Использовано Heap» помогает понять, сопровождается ли рост GC увеличением занятого
heap. - «Кол-во потоков» может оставаться стабильным, если проблема связана не с количеством потоков, а с профилем обработки событий.
- «Использование Heap, %» помогает отделить рост времени GC при рабочем уровне памяти от сценария, где JVM приближается к нехватке
heap.
Практическая интерпретация:
- Растет преимущественно Young GC - Logstash, вероятно, создает много временных объектов. Проверьте объем входящих событий, тяжелые фильтры, преобразование строк, разбор JSON/XML и batch-обработку.
- Растет Old GC - появляются признаки утечки памяти. Проверьте очереди, крупные события, retry/backoff в
output-плагинах, кэши и пользовательские фильтры. - Растут Old GC и «Использовано Heap» - сценарий похож на устойчивое накопление объектов. Увеличение
heapможет снизить частоту проявления проблемы, но не всегда устраняет причину. - GC растет, но «Использовано Heap» возвращается к обычному диапазону - вероятнее причина в профиле аллокаций или временном пике нагрузки, а не в утечке памяти.
Для проверки такого сценария сопоставьте время роста GC с изменениями в pipeline, объемом входящих событий, размером batch, состоянием очередей и ошибками output-плагинов. Если рост GC совпадает с задержками записи во внешнюю систему, Logstash может удерживать события в памяти дольше обычного, хотя первичная причина находится за пределами JVM.