Дашборд «Мониторинг Logstash»
Описание статьи
Дашборд используется для контроля состояния узлов Logstash, через которые проходят сбор, обработка и передача событий в Smart Monitor. Он помогает быстро понять, доступен ли процесс Logstash, хватает ли узлу CPU и памяти JVM, а также нет ли признаков задержки на входе, в pipeline или на стороне выходных плагинов.
Состав дашборда
Глобальные и локальные фильтры
На дашборде доступны следующие элементы управления:
Временной диапазонзадает период просмотра данныхИмя хоставыбирает узел Logstash для детализацииТипограничивает журнал сообщений по типу записиТегпомогает отфильтровать журнал по тегу сообщения
Цветовая индикация
Цветовая индикация помогает быстро заметить показатели, которые требуют проверки. Ее нужно использовать как ориентир для первичной оценки, а не как самостоятельное доказательство проблемы.
Метрики дашборда
Идентификация и оперативное состояние
| Панель | Что показывает | Когда смотреть | Ориентиры штатной работы | Когда нужна дополнительная проверка |
|---|---|---|---|---|
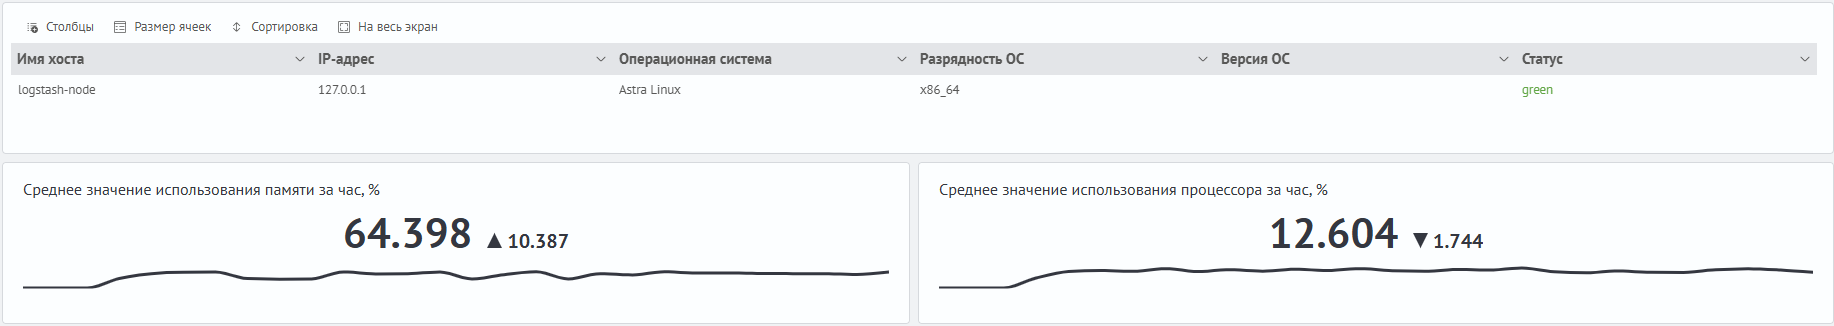
| Таблица идентификации узла | Имя и IP-адрес хоста, параметры операционной системы и статус Logstash. | В начале диагностики, чтобы проверить выбранный узел и базовое состояние Logstash. | Статус соответствует ожидаемому состоянию процесса, данные обновляются. | Отсутствие свежих данных или недоступность процесса требует проверки сервиса, журналов и канала сбора метрик. |
| «Среднее значение использования памяти за час, %» | Сводный показатель использования JVM Heap. | При подозрении на нехватку памяти, частые паузы GC или нестабильную обработку событий. | После пиков heap возвращается к обычному диапазону, а GC заметно не влияет на обработку. | Продолжительный рост или сокращение запаса стоит сопоставить с GC, потоком событий, очередью и ошибками памяти. |
| «Среднее значение использования процессора за час, %» | Сводный показатель загрузки CPU процессом Logstash. | При поиске вычислительного ограничения, перегрузки фильтров или output-плагинов. | CPU меняется вместе с входящим потоком, а пропускная способность сохраняется. | Устойчивая загрузка требует внимания, если одновременно снижается скорость обработки, растет backpressure. |
Ресурсы CPU и JVM
| Панель | Что показывает | Когда смотреть |
|---|---|---|
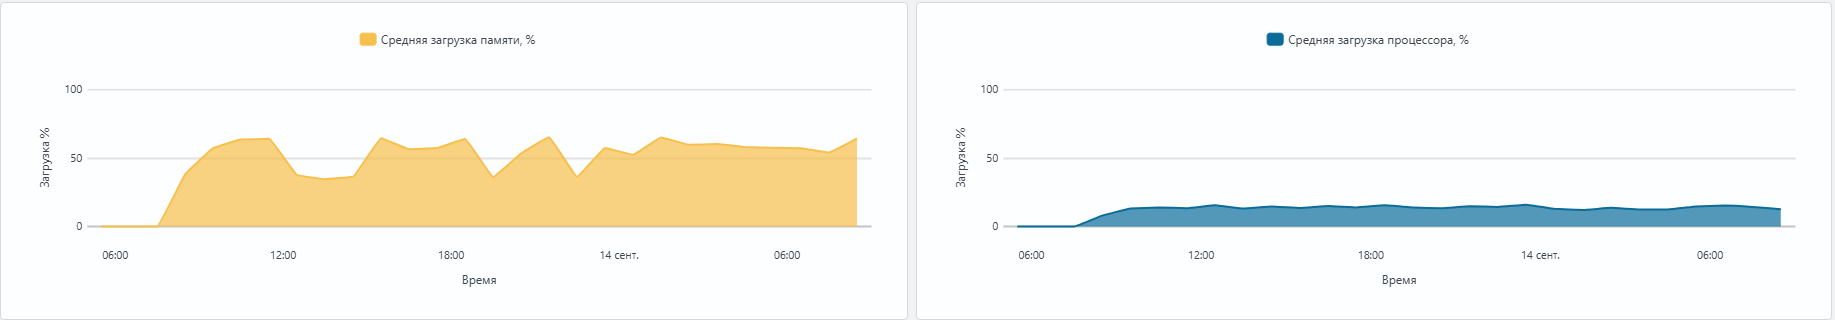
| «Средняя загрузка памяти, %» | Динамику использования JVM Heap на выбранном узле. | Когда нужно понять, растет ли давление на память и совпадает ли оно с задержками обработки. |
| «Средняя загрузка процессора, %» | Динамику загрузки CPU процессом Logstash. | При длительных периодах высокой нагрузки, резких скачках CPU или снижении пропускной способности. |
Поток событий
| Панель | Что показывает | Когда смотреть | Ориентиры штатной работы | Когда нужна дополнительная проверка |
|---|---|---|---|---|
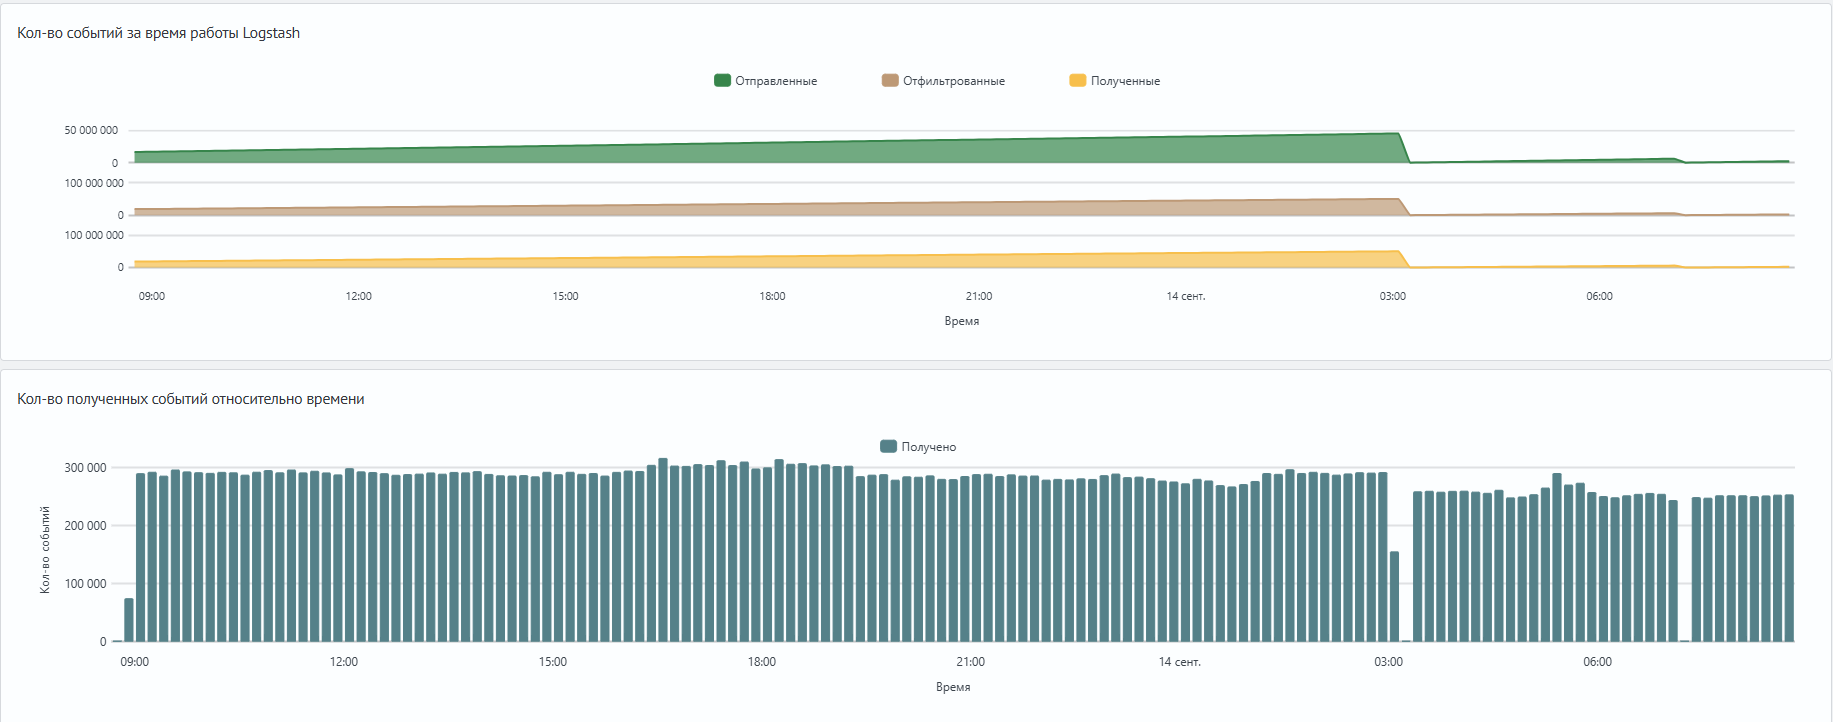
| «Кол-во событий за время работы Logstash» | Соотношение входящих, обработанных и отправленных событий. | При подозрении на задержку обработки, отставание отправки или изменение пропускной способности. | Счетчики растут в соответствии с логикой pipeline; различия объясняются фильтрацией, клонированием, агрегацией или повторной обработкой. | Расхождение не доказывает очередь или потерю. Проверка нужна, если скорости приема и отправки устойчиво расходятся и это совпадает с ошибками, backpressure и ростом очереди. |
| «Кол-во полученных событий относительно времени» | Динамику поступления событий на вход Logstash. | Когда нужно найти интервалы роста входящего потока и сопоставить их с нагрузкой CPU, JVM и output-плагинов. | Входящий поток остается в пределах производительности pipeline и системы приема данных. | Рост важен, если обработка и отправка не успевают за приемом, увеличивается задержка или появляются ошибки плагинов. |
Метрики коллектора
| Панель | Что показывает | Когда смотреть | Регулируемые параметры | Ориентиры штатной работы | Когда нужна дополнительная проверка |
|---|---|---|---|---|---|
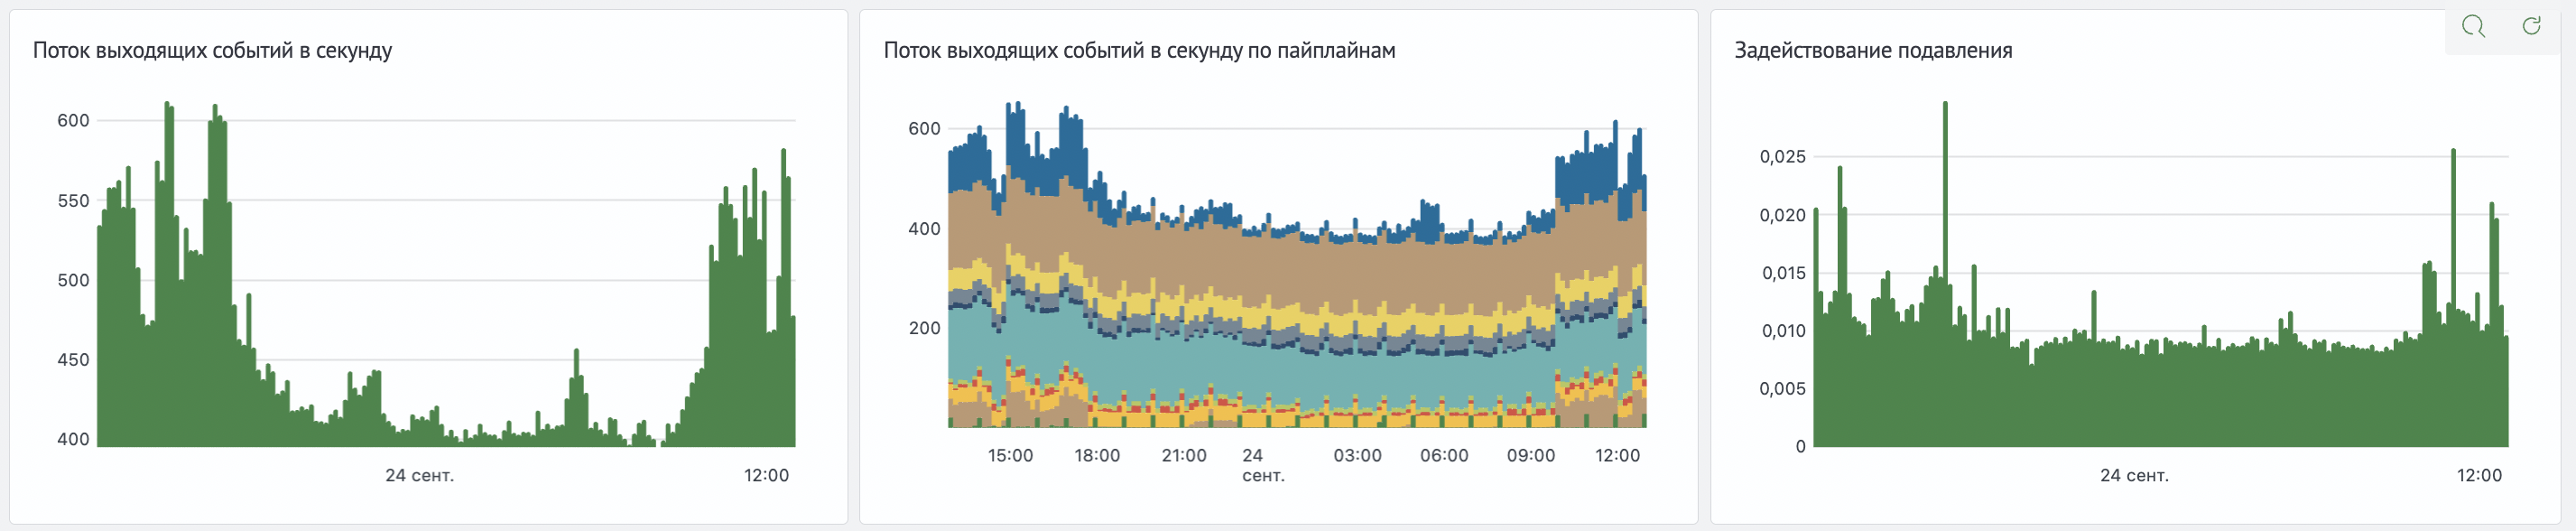
| «Поток выходящих событий в секунду по пайплайнам» | Распределение выходного потока событий между pipeline. | Когда нужно определить, какой pipeline связан со снижением или изменением общей скорости передачи событий. | pipeline.workers, pipeline.batch.size соответствующего pipeline. Текущие значения: панель «Информация о pipelines» или GET /_node/pipelines?pretty. Изменение: pipelines.yml; общие значения — logstash.yml. | Распределение соответствует назначению и обычной нагрузке каждого pipeline. | Снижение на одном pipeline при стабильном входе помогает выбрать участок проверки, но причину нужно уточнять по его плагинам, очереди и журналам. |
| «Поток выходящих событий в секунду» | Общую скорость передачи событий коллектором. | При снижении объема данных на выходе или расхождении между входным и выходным потоком. | pipeline.workers, pipeline.batch.size. Текущие значения: панель «Информация о pipelines» или GET /_node/pipelines?pretty. Изменение: для отдельного pipeline — pipelines.yml, для общих значений — logstash.yml. | Скорость соответствует входному потоку с учетом логики обработки и согласованной пропускной способности. | Продолжительное снижение стоит сопоставить с входным потоком, ошибками output-плагинов, backpressure и состоянием системы приема данных. |
| «Задействование подавления» | Наличие ограничения скорости обработки или передачи событий коллектором. | При росте throttling и снижении выходного потока, когда нужно проверить фильтры, output-плагины и доступные ресурсы pipeline. | pipeline.workers, pipeline.batch.size; при использовании persistent queue — queue.type и queue.max_bytes. Текущие workers и batch_size: GET /_node/pipelines?pretty; параметры очереди: pipelines.yml или logstash.yml. Изменение: pipelines.yml для отдельного pipeline, logstash.yml для общих значений. Увеличение очереди только дольше поглощает всплеск и не устраняет ограничение фильтра или output-плагина. | Кратковременное ограничение не приводит к устойчивому отставанию выходного потока и нарушению требований к задержке. | Продолжительный рост вместе со снижением выходной скорости или ростом очереди может указывать на ограничение обработки либо системы-получателя. |
Pipeline и горячие потоки
| Панель | Что показывает | Когда смотреть | Регулируемые параметры | Ориентиры штатной работы | Когда нужна дополнительная проверка |
|---|---|---|---|---|---|
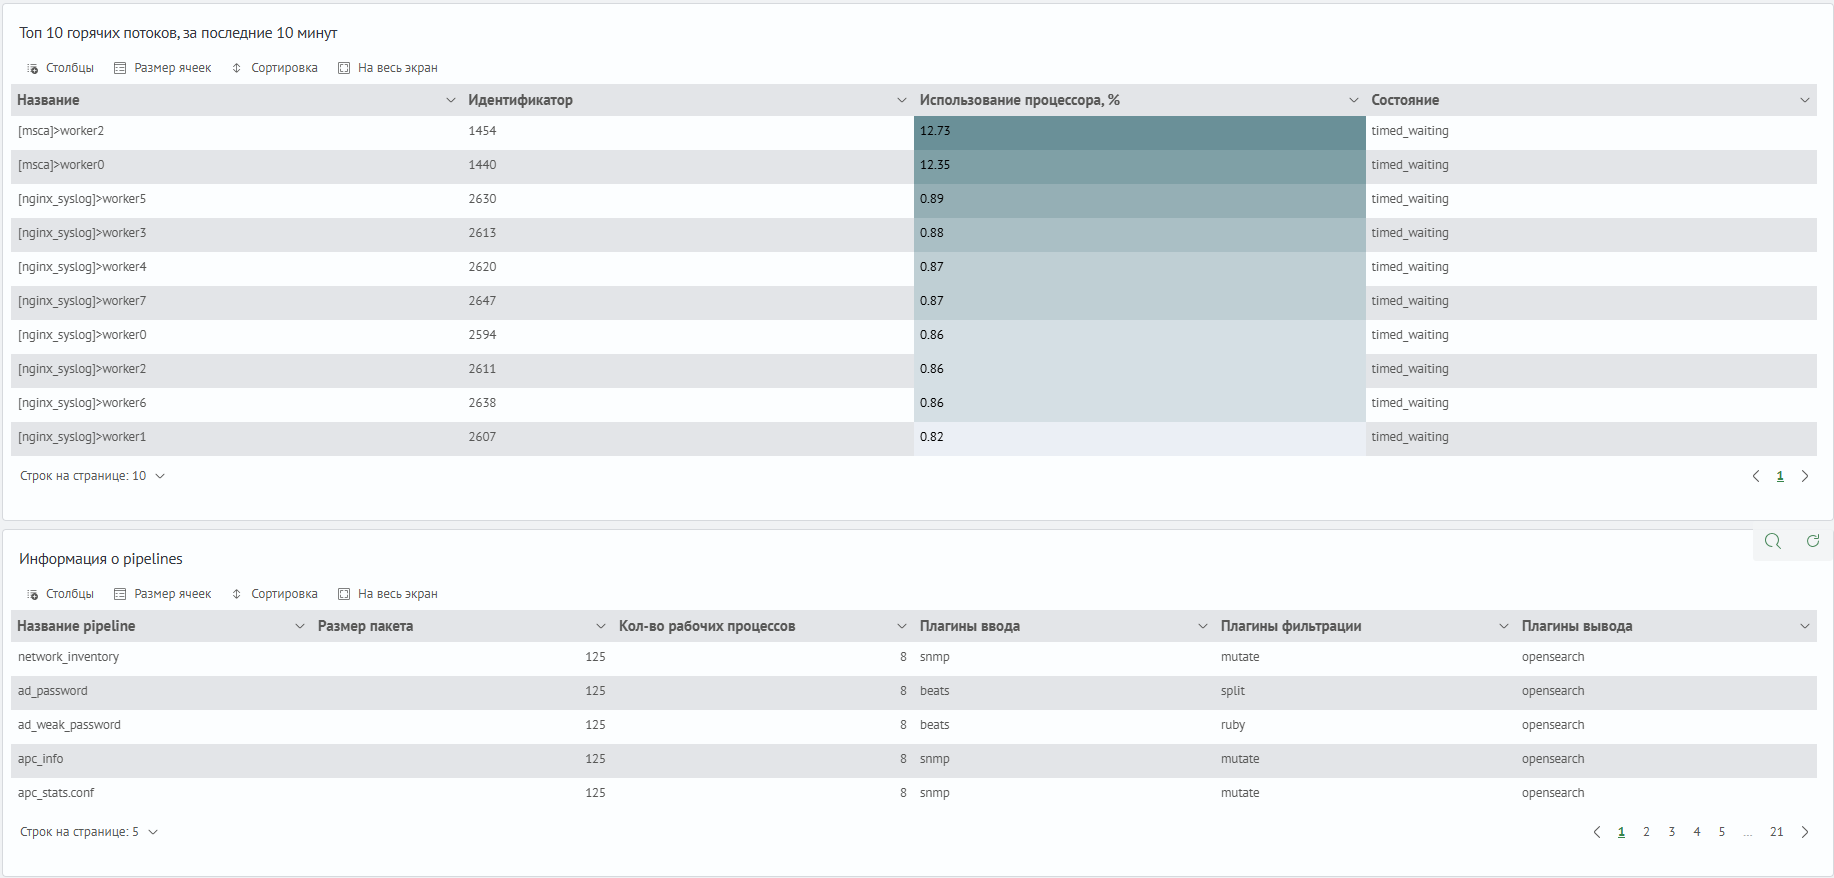
| «Топ 10 горячих потоков, за последние 10 минут» | Наиболее загруженные потоки JVM, их идентификаторы, использование CPU и состояние. | При устойчивой высокой загрузке CPU, когда нужно определить, какой pipeline требует дальнейшей проверки. | pipeline.workers. Изменение: pipelines.yml, общее значение - в logstash.yml. | Состав верхних строк меняется вместе с текущей работой pipeline, а CPU и пропускная способность остаются приемлемыми. | Повторяющееся появление потоков одного pipeline является поводом проверить его первым, если одновременно наблюдается высокая загрузка CPU или снижение производительности. |
| «Информация о pipelines» | Настройки pipeline: размер пакета, количество рабочих потоков и списки плагинов ввода, фильтрации и вывода. | При проверке конфигурации обработки, изменениях правил или поиске участка, который может ограничивать производительность. | pipeline.workers, pipeline.batch.size, pipeline.batch.delay. Панель показывает текущие значения; изменение: pipelines.yml для отдельного pipeline, logstash.yml для общих значений. | - | - |
Журналы и ошибки
| Панель | Что показывает | Когда смотреть |
|---|---|---|
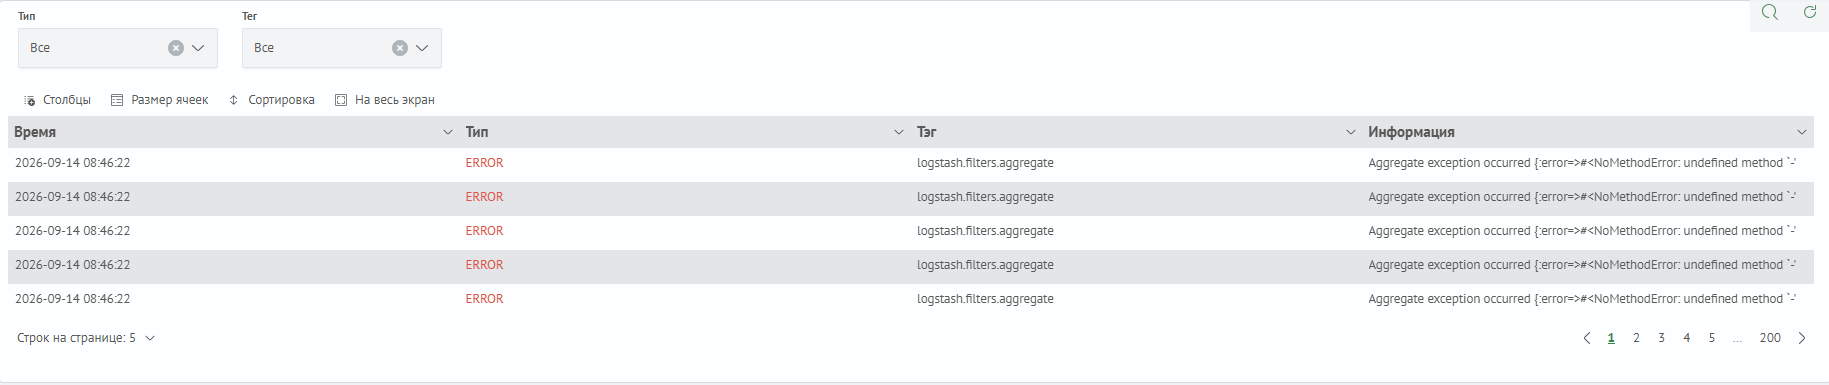
| Журнал сообщений | Сообщения Logstash с временем, типом, тегом и текстом записи. | Для восстановления хронологии события и проверки ошибок плагинов. |
| «Агрегация ошибок» | Группы повторяющихся предупреждений и ошибок. | Когда нужно уменьшить шум в журналах и сначала разобрать самые частые сообщения. |
Примеры диагностики проблем
Где искать подробности
| Признак или отклонение | Где смотреть подробности |
|---|---|
| Процесс Logstash недоступен или по узлу нет свежих данных | Текущий дашборд: идентификация узла и журнальные панели |
| Растет JVM Heap, появляются признаки пауз GC или нехватки памяти | «Мониторинг JVM ноды Logstash» |
| Устойчивая высокая загрузка CPU на узле Logstash | Текущий дашборд: таблица Hot Threads и таблица Pipelines; «Мониторинг JVM ноды Logstash» |
| Входящий поток растет быстрее, чем отправка событий | Текущий дашборд: графики событий, журнал сообщений и агрегация ошибок |
| Ошибки или задержки связаны с output-плагинами | «Мониторинг производительности индексирования», «Состояние кластера» |
| Повторяются однотипные ошибки в журналах Logstash | Текущий дашборд: журнал сообщений и агрегация ошибок |
| Деградация сбора данных совпадает с проблемами хранения или индексирования | «Мониторинг производительности индексирования», «Состояние кластера» |
Первичная оценка состояния Logstash
Начинайте проверку с общего признака: недоступен Logstash, растет CPU или JVM Heap, расходятся счетчики событий, появляются ошибки output-плагинов или повторяющиеся сообщения в журнале. Эти признаки помогают выбрать направление диагностики, но не являются самостоятельной причиной инцидента.
Для первичной оценки сопоставьте ресурсные показатели, графики событий и сообщения журналов в одном временном интервале. Это помогает отделить ресурсную нагрузку от проблем обработки и отправки событий.
Анализ ресурсов CPU и JVM
CPU и JVM Heap анализируйте по динамике, а не по одному значению. Короткий пик может быть связан с разовым всплеском входящего потока, а длительная высокая нагрузка чаще требует проверки pipeline, фильтров, output-плагинов и состояния приемника.
При устойчивой загрузке CPU проверьте, повторяются ли в Hot Threads одни и те же worker-потоки. Одновременный рост JVM Heap или признаки пауз GC указывают, что деградация может быть связана не только с вычислительной нагрузкой, но и с состоянием JVM.
Анализ потока событий
Для анализа выберите интервал, в котором началось расхождение потоков, и сопоставьте его с загрузкой CPU, использованием JVM Heap и сообщениями output-плагинов. Это поможет определить, на каком этапе появилось отставание: при обработке событий или при их отправке.
Проверка pipeline и горячих потоков
Таблица Hot Threads помогает выбрать pipeline, который стоит проверить первым при высокой загрузке CPU. По имени worker-потока можно определить связанный pipeline, но сама таблица не указывает конкретный фильтр, плагин или строку конфигурации.
Для детальной проверки работы pipeline можно использовать Node Stats API Logstash:
curl -s 'http://localhost:9600/_node/stats/pipelines?pretty'
Ответ содержит runtime-статистику по каждому pipeline: счетчики входящих, обработанных и отправленных событий, показатели пропускной способности, сведения об очереди и статистику filter- и output-плагинов. Для проверки одного pipeline его идентификатор можно указать в пути:
curl -s 'http://localhost:9600/_node/stats/pipelines/<pipeline_id>?pretty'
При анализе нужно сопоставить:
events.in,events.filteredиevents.out- показатели пропускной способности в разделе
flow flow.worker_utilizationиflow.worker_concurrencyflow.queue_backpressure- статистику filter- и output-плагинов
Node Stats API показывает статистику выполнения, но не заменяет проверку конфигурации. Значения pipeline.workers и pipeline.batch.size нужно сверять с настройками соответствующего pipeline.
Проверка событий и ошибок
Журналы используйте для подтверждения причины после того, как по метрикам определен симптом и примерный интервал. Сначала восстановите хронологию: когда началось отклонение, какие сообщения появились рядом с ним и какие pipeline или плагины в них фигурируют.
Повторяющиеся ошибки проверяйте вместе с графиками событий и ресурсами узла. Одинаковые сообщения могут быть следствием одной причины, но сам факт повторения не объясняет источник проблемы без сопоставления с метриками.
Типовые сценарии
Косвенные признаки снижения пропускной способности
Обратное давление (back pressure) возникает, когда Logstash не успевает отправлять события с той скоростью, с которой они поступают на вход. Причина может быть связана с обработкой данных в Logstash или с ограничением на стороне системы приема данных.
Дашборд показывает косвенные признаки возможного обратного давления, но не измеряет его напрямую. Расхождение счетчиков событий нужно подтверждать через журналы, состояние output-плагинов и сопоставление с системой приема данных. Наличие очереди и ее размер по одному графику определить нельзя.
На дашборде это может проявляться так:
- на графике событий входящий поток растет быстрее, чем отправка
- после периода высокого поступления событий отправка не возвращается к ожидаемому уровню
- в журналах появляются повторяющиеся ошибки отправки или ограничения со стороны приемника

На изображении показан график накопительных счетчиков событий за время работы Logstash. Такой график не является самостоятельным доказательством обратного давления, но помогает заметить расхождение между входом, обработкой и отправкой и выбрать следующий участок проверки: обработку в Logstash, output-плагин или систему приема данных.
Высокая загрузка CPU в таблице «Топ 10 горячих потоков, за последние 10 минут»
При устойчивой высокой загрузке CPU сравните несколько последовательных срезов Hot Threads. Если в верхних строках регулярно появляются worker-потоки одного pipeline, сопоставьте его runtime-статистику со списком плагинов, журналами и последними изменениями конфигурации.
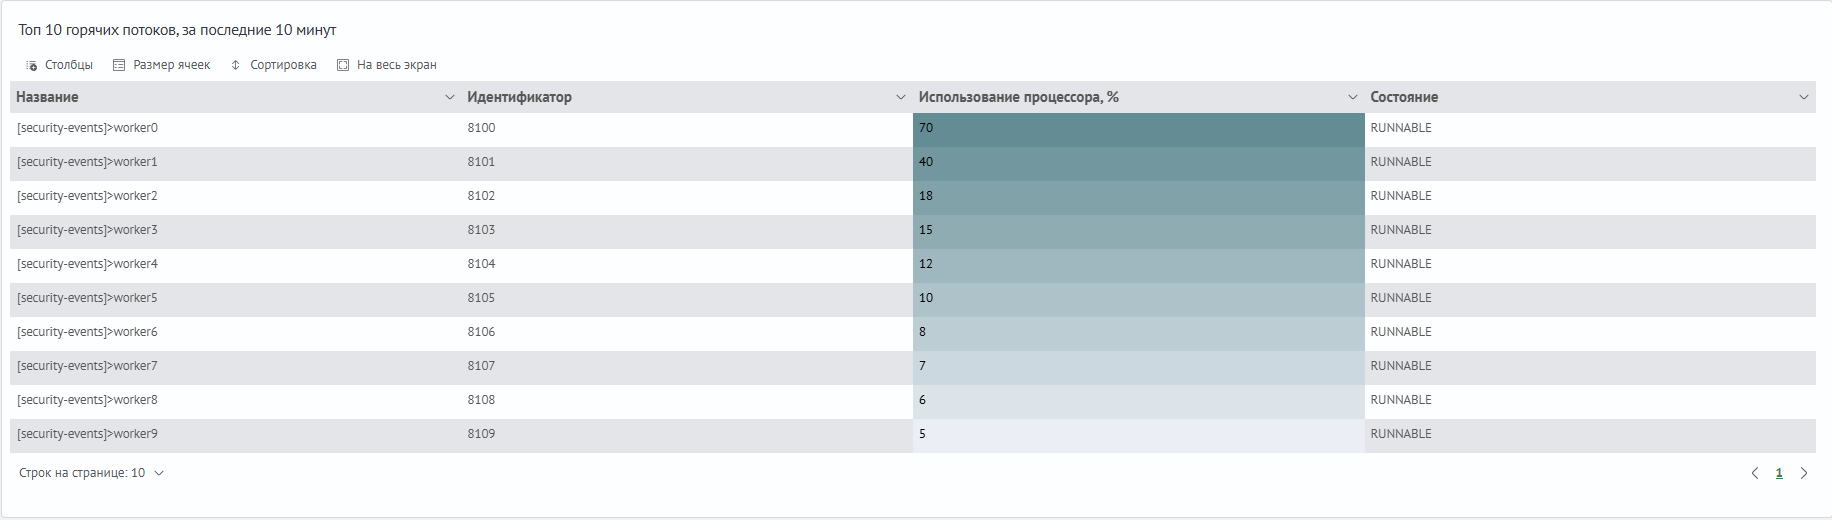
На изображении показан пример таблицы Hot Threads, где верхние строки занимают worker-потоки одного pipeline. Такой вид таблицы помогает выбрать pipeline для дальнейшей проверки, но не указывает сам по себе на конкретный фильтр, плагин или строку конфигурации.
Если вместе с высокой загрузкой CPU растет heap или появляются длительные паузы GC, это нужно учитывать как отдельный фактор деградации JVM, а не только как проблему вычислительной нагрузки конкретного pipeline.