Дашборд «Состояние кластера»
Описание статьи
Дашборд используется для анализа состояния кластера Smart Monitor за выбранный период. Он показывает статус кластера, изменение количества узлов, состояние шардов, ресурсные метрики узлов и связанные сообщения журналов.
Панели помогают обнаружить изменение состояния и определить направление дальнейшей проверки.
Состав дашборда
Глобальные и локальные фильтры
На дашборде доступны следующие элементы управления:
Периодзадает временной диапазон просмотра данныхКритичностьограничивает журнал сообщений по уровню важностиПоиск по сообщениямпомогает найти записи по тексту сообщения
Цветовая индикация
Цветовая индикация помогает быстро заметить показатели, которые требуют проверки. Ее нужно использовать как ориентир для первичной оценки, а не как самостоятельное доказательство проблемы.
Если цветовая зона указывает на возможный дефицит ресурса, проверьте динамику показателя и сопоставьте ее со статусом кластера, состоянием шардов и сообщениями журналов.
Метрики дашборда
Верхние индикаторы состояния

| Панель | Что показывает | Когда смотреть | Ориентиры штатной работы | Когда нужна дополнительная проверка |
|---|---|---|---|---|
| «Статус» | Общее состояние аллокации шардов в кластере. | В начале диагностики, при недоступности данных, ошибках поиска и/или записи. | Состояние соответствует ожидаемой схеме размещения шардов. | Переход в yellow стоит проверить, если он не связан с известными работами или сохраняется дольше ожидаемого. red требует определения неразмещенных первичных шардов и оценки доступности затронутых данных. |
| «Активные ноды» | Количество узлов, участвующих в работе кластера. | При подозрении на потерю узла, сетевую проблему или перезапуск сервиса. | Количество узлов соответствует утвержденной архитектуре либо известному периоду обслуживания. | Неожиданное снижение или частые изменения числа узлов стоит сопоставить со статусом кластера и журналами. |
Состояние и распределение шардов
| Панель | Что показывает | Когда смотреть | Ориентиры штатной работы | Когда нужна дополнительная проверка |
|---|---|---|---|---|
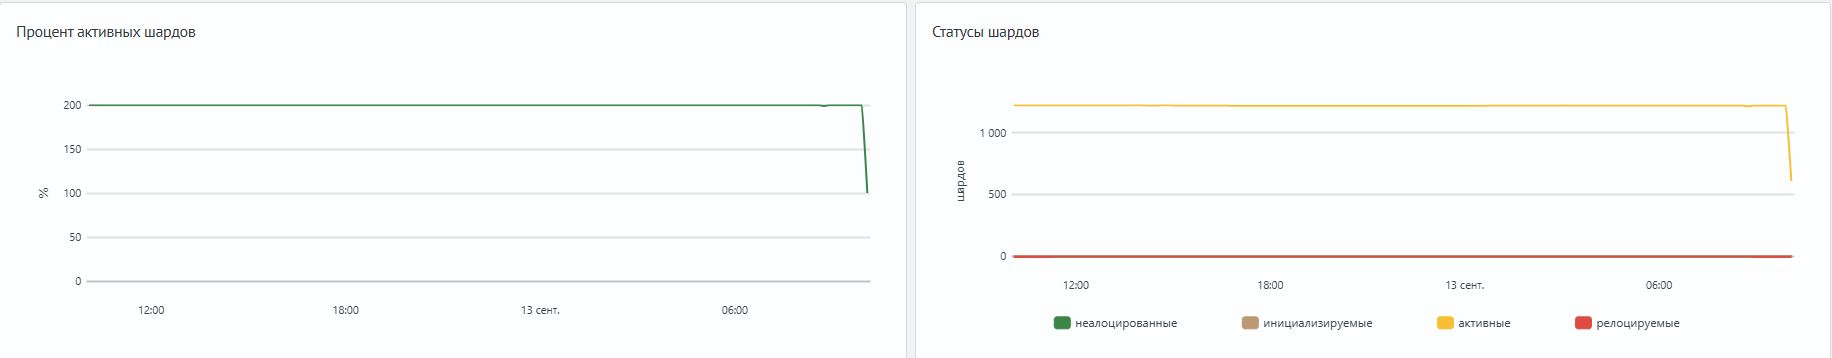
| «Процент активных шардов» | Долю шардов, доступных для поиска. | При изменении статуса кластера, восстановлении после сбоя или проверке полноты аллокации. | Показатель возвращается к ожидаемому уровню после восстановления или перемещения шардов. | Снижение требует проверки, если оно сохраняется, сопровождается ростом UNASSIGNED или затрагивает первичные шарды. Сам процент не показывает, какие данные затронуты. |
| «Статусы шардов» | Распределение шардов по состояниям: активные, инициализируемые, перемещаемые и неаллоцированные. | Когда нужно понять, идет ли восстановление, перемещение или есть проблема с размещением шардов. | Инициализируемые и перемещаемые шарды со временем переходят в активное состояние; число неаллоцированных шардов не растет. | Продолжительное сохранение INITIALIZING или RELOCATING, а также появление UNASSIGNED стоит проверить по типу копии, причине отказа в аллокации и доступным ресурсам. |
Сводная таблица узлов

| Панель | Что показывает | Когда смотреть | Ориентиры штатной работы | Когда нужна дополнительная проверка |
|---|---|---|---|---|
| «Сводная таблица узлов» | Ресурсные показатели узлов: сегменты, CPU, память, хранилище, HTTP-соединения, файловые дескрипторы, heap и потоки. | Когда нужно определить, какой узел требует дальнейшей проверки. | Ресурсные показатели сопоставимы между узлами одинаковой роли и остаются в пределах эксплуатационных ограничений. | Выделяющийся узел следует проверять, если отличие сохраняется и совпадает с изменением статуса, аллокации шардов, задержки или числа ошибок. |
Журнальные панели

| Панель | Что показывает | Когда смотреть |
|---|---|---|
| «Журнал важных сообщений» | Критические и предупреждающие сообщения кластера. | После изменения статуса, потери узла, появления неаллоцированных шардов или ошибок записи и/или поиска. |
| «Журнал сообщений кластера» | Детальные сообщения кластера для восстановления хронологии события. | Когда нужно перейти от общего признака к конкретным сообщениям и времени их появления. |
| «Агрегация ошибок» | Повторяющиеся сообщения и группы однотипных ошибок. | Когда нужно оценить масштаб проблемы и найти наиболее частые сообщения за выбранный период. |
Примеры диагностики проблем
Где искать подробности
| Признак или отклонение | Где смотреть подробности |
|---|---|
| Потеря узла или снижение количества активных узлов | «Мониторинг ресурсов ноды», «Мониторинг JVM ноды» |
| Неаллоцированные шарды или изменение статуса кластера | Текущий дашборд, «Мониторинг ресурсов ноды» |
| Заполнение диска или проблемы размещения шардов | «Мониторинг ресурсов ноды», «Мониторинг производительности индексирования» |
| Рост поисковой нагрузки или ошибки поиска | «Мониторинг производительности запросов», «Число запросов в кластере по типу» |
| Ошибки записи или деградация индексирования | «Мониторинг производительности индексирования» |
| Проблемы сбора данных | «Мониторинг Logstash», «Мониторинг JVM ноды Logstash» |
| Повторяющиеся ошибки в журналах | Текущий дашборд: журнальные панели и агрегация ошибок |
Первичная оценка состояния кластера
По таблицам метрик определите, какой показатель перестал соответствовать ориентирам штатной работы или соответствует условию дополнительной проверки. Зафиксируйте момент изменения и сопоставьте значения за один и тот же интервал.
Определите масштаб отклонения: весь кластер, отдельный узел или шарды конкретного индекса. При изменении статуса или состава кластера перейдите к следующему разделу; для неаллоцированных шардов — к анализу аллокации; для ресурсных отклонений — к проверке ресурсных причин.
Анализ изменения статуса и состава кластера
Сначала сопоставьте изменение статуса с количеством активных узлов и событиями в журналах за тот же интервал.
Статус yellow означает, что все первичные шарды доступны, но часть реплик не размещена. Определите, почему кластер не может разместить нужное количество реплик.
Статус red означает, что хотя бы один первичный шард не размещен. Часть данных может быть недоступна, а поиск может выдавать неполные результаты. Определите, связано ли изменение с потерей узла, нехваткой ресурсов, правилами аллокации или ошибками восстановления.
Если количество активных узлов снизилось, начните с проверки доступности затронутого узла. Если узел вернулся, но шарды остались неаллоцированными, переходите к анализу причин отказа в аллокации.
Анализ аллокации шардов
Для проверки состояния и распределения шардов выполните GET-запрос в Консоли разработчика:
GET /_cat/shards?v
В выводе определите индекс, номер шарда, тип копии (p — первичный шард, r — реплика), состояние и узел размещения. Для шарда в состоянии UNASSIGNED укажите его индекс, номер и тип копии в теле GET-запроса:
GET /_cluster/allocation/explain
{
    "index": "<имя_индекса>",
    "shard": 0,
    "primary": true
}
Значение primary равно true для первичного шарда и false для реплики. Без тела запрос возвращает объяснение для первого найденного неаллоцированного шарда.
Проверка ресурсных причин
После определения затронутого индекса или шарда найдите в сводной таблице узлы, на которых в тот же интервал изменились ресурсные показатели. Сопоставьте эти изменения со статусом кластера и состоянием шардов.
По типу выявленного отклонения выберите в таблице «Где искать подробности» детализирующий дашборд и продолжите проверку на нем.
Проверка событий и ошибок
После определения отклонения и интервала откройте «Журнал важных сообщений», затем — «Журнал сообщений кластера». Восстановите хронологию: когда изменился статус, какие узлы были затронуты и какие сообщения появились рядом с этим изменением.
После этого используйте «Агрегацию ошибок», чтобы оценить повторяемость сообщений. Сопоставьте повторяющиеся ошибки с состоянием шардов и ресурсами узлов: сам факт повторения не объясняет источник проблемы.
Типовые сценарии
Исключение узла
Сценарий возникает, когда узел теряет сетевую связность с остальными участниками либо перестает отвечать на проверки доступности. Кластер-менеджер исключает его из состава кластера, и находившиеся на нем копии шардов становятся недоступными.
При наличии доступных реплик OpenSearch может повысить реплику до первичного шарда и восстановить недостающие копии на других узлах. Если подходящих копий или ресурсов для размещения нет, часть шардов остается в состоянии UNASSIGNED.
На дашборде это проявляется так:
- «Статус» изменяется на
yellowилиred - значение «Активные ноды» снижается
- уменьшается «Процент активных шардов»
- на графике «Статусы шардов» меняется количество неаллоцированных шардов
Рассмотрим кластер из двух узлов: первый узел имеет роли master + data, второй — роль data. Количество реплик равно единице. Узел с ролью data был исключен:

На изображении статус изменился на yellow, значение «Активные ноды» снизилось до 1, процент активных шардов — примерно до 70%, а часть шардов перешла в состояние UNASSIGNED.
Переполнение дискового пространства
При длительной эксплуатации без настроенных политик ISM или при резком росте объема входящих данных свободное место на узлах SM Data Storage может исчерпаться. Последствия зависят от настроек дисковых порогов и от того, стали ли недоступны первичные шарды.
На дашборде это проявляется так:
- «Статус» может измениться на
yellowилиred - в сводной таблице значение показателя «Хранилище, %» для одного или нескольких узлов приближается к 100%
- на графике «Статусы шардов» меняется количество неаллоцированных шардов
Рассмотрим кластер из двух узлов: первый узел имеет роли master + data, второй — роль data. На узле с ролью data диск заполнился до 100%:
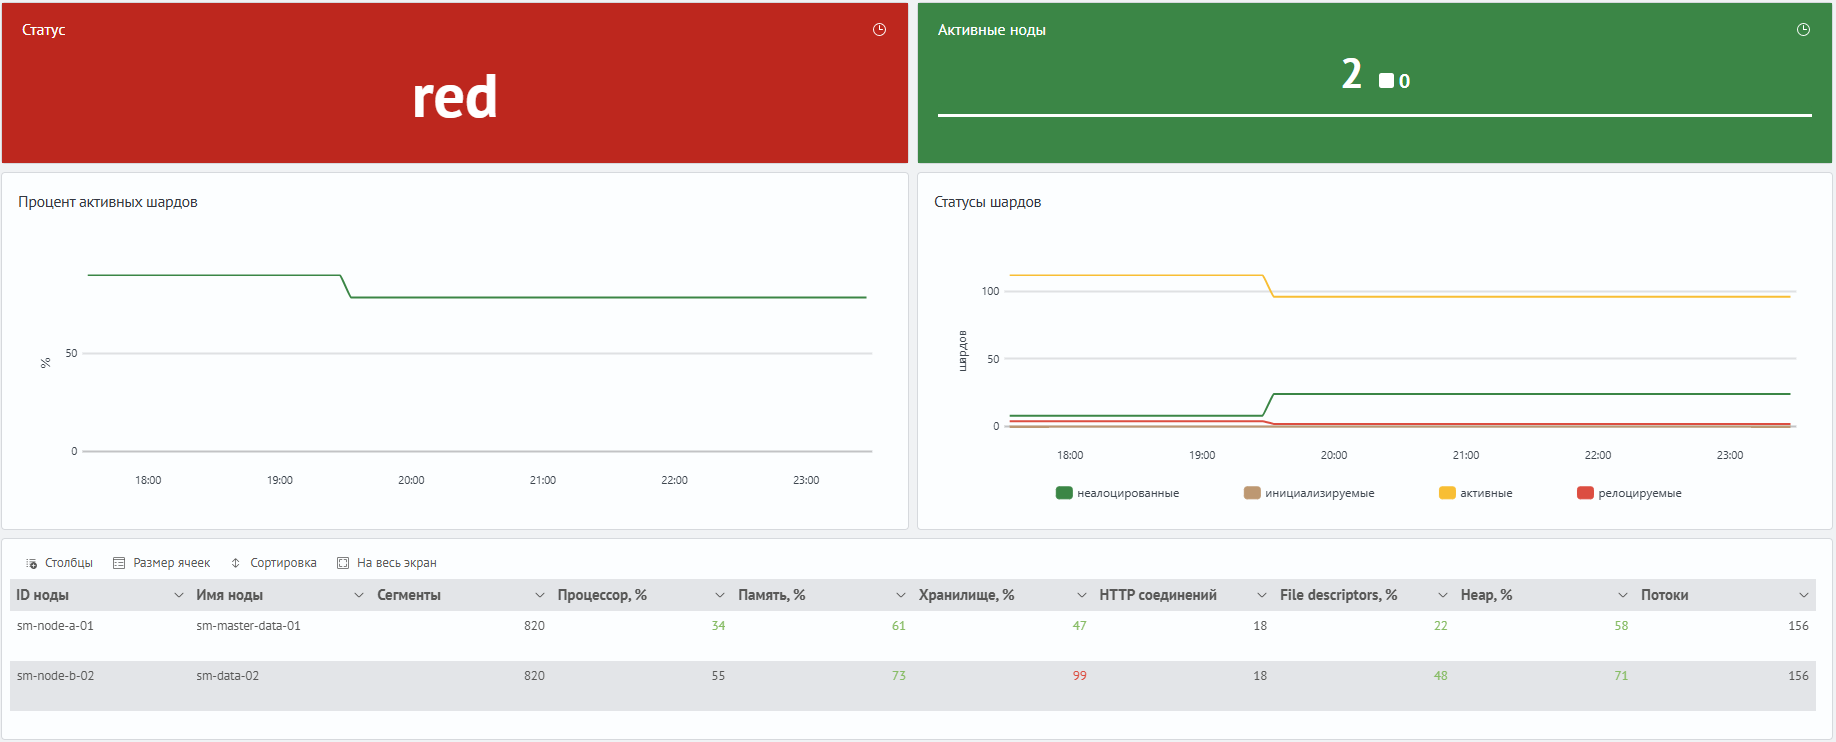
На изображении активными остаются два узла, но в сводной таблице значение «Хранилище, %» проблемного узла достигает 99%, появляются шарды в состоянии UNASSIGNED, а статус изменяется на red. В показанном случае недоступными стали один или несколько первичных шардов; заполнение диска само по себе не является обязательной причиной статуса red.
В Smart Monitor дисковые пороги аллокации по умолчанию отключены. Если они не были включены при настройке контура, кластер продолжает использовать дисковое пространство без защитной реакции на пороги high watermark и flood_stage. При исчерпании свободного места возможны ошибки записи, восстановления и размещения шардов, нестабильность узла и появление неаллоцированных шардов.
Инструкцию по настройке Disk Watermark можно найти в соответствующей статье.
Если после освобождения места шарды остались в состоянии UNASSIGNED, сначала устраните причину отказа в аллокации.
POST-запрос для ручной повторной попытки размещения шардов:
POST /_cluster/reroute?retry_failed=true